2026/08/02 4

[세컨드브레인 개발기] 4. 위키가 영어로 쓰여 있었다 — 4,382개 중 482개

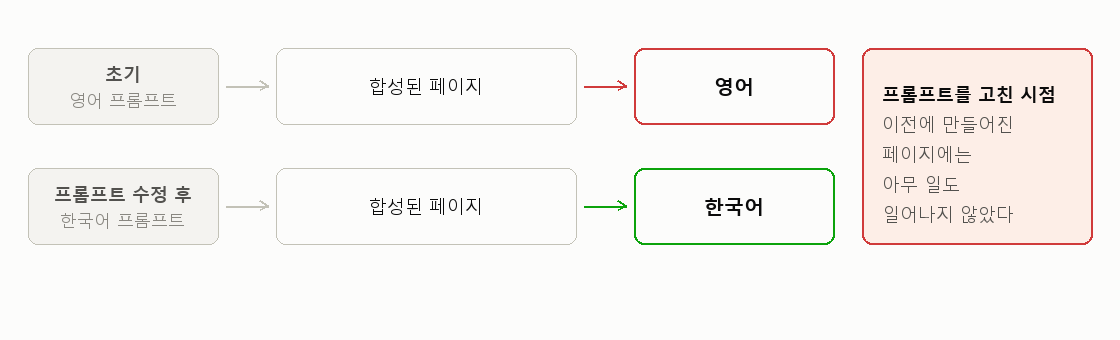
[세컨드브레인 개발기] 4. 위키가 영어로 쓰여 있었다 — 4,382개 중 482개1부의 마지막 편입니다. 앞 세 편에서 세컨드브레인을 LLM-Wiki 패턴으로 시작하고, 문서 2만 개를 만나 벡터 검색 계층을 얹고, 온갖 파일 포맷에서 텍스트를 꺼내는 이야기를 썼습니다. 이 편은, 그렇게 만든 위키를 열어봤을 때 생긴 일입니다. 2주쯤 지나 브라우징 화면을 붙였고, 페이지를 넘겨보다가 이상한 걸 발견했습니다. 일부 페이지가 영어로 쓰여 있었습니다. 내 자료는 거의 전부 한국어인데, 합성된 페이지가 영어라니. 아무도 부탁하지 않은 번역이었죠. 왜 그랬는지부터 보겠습니다. 원인은 금방 찾았는데, ingest 시 LLM에 주는 시스템 프롬프트에 한국어로 작성 지시가 이미 있었습니다. 어라, 지금 규칙은 맞..
공부/인공지능 2026.08.02

[세컨드브레인 개발기] 3. 20k 문서를 실제로 읽어들이기 — 로더 지옥

[세컨드브레인 개발기] 3. 20k 문서를 실제로 읽어들이기 — 로더 지옥앞 편에서 문서 2만 개를 만나 설계를 고친 이야기를 썼습니다. 벡터 검색 계층을 얹고, 청크로 쪼개서 임베딩하면 된다고 적었는데, 그 문장에는 앞 단계가 하나 빠져 있습니다. 파일에서 텍스트를 꺼내는 일. 이게 이 프로젝트에서 제일 지루하고, 제일 오래 걸리고, 블로그에서 아무도 안 쓰는 부분입니다. RAG 튜토리얼은 대부분 PyPDFLoader 한 줄로 끝나요. 실제 자료는 그렇게 생기지 않았습니다. 공문 하나만 열어봐도 한글 파일이 나오고, 구형 오피스 파일이 나오고, 스캔 이미지가 나옵니다. 이 글이 그 삽질을 반복하지 않게 해주면 좋겠습니다.처리해야 했던 포맷 드라이브에서 당겨온 파일의 확장자를 세어보고 정리한 목록입니다...

공부/인공지능 2026.08.02

[세컨드브레인 개발기] 2. 20,000개 문서 앞에서 설계가 무너진 날

[세컨드브레인 개발기] 2. 20,000개 문서 앞에서 설계가 무너진 날앞 편에서, 개인 연구용 세컨드브레인을 벡터 RAG 없이 시작한 이야기를 썼습니다. 소스가 들어올 때 LLM이 한 번 읽고 링크 걸린 마크다운으로 다시 쓰는 방식(Karpathy의 LLM-Wiki 패턴)이고, 근거 중 하나가 "개인 규모에서는 사전합성이 RAG를 이긴다"였습니다. 2026년 6월 2일에 그게 엔드투엔드로 돌아가는 걸 확인했습니다. 같은 날 설계가 깨졌습니다. 이 편은 그 이야기고, 시리즈에서 제일 중요한 편이라고 생각합니다.산수 한 줄로 끝났다 구글드라이브에는 대학 두 곳에서 일하며 만든 자료가 예전부터 쌓여 있었습니다. 브레인에 넣을 대상으로 그 폴더를 지정하고, 규모를 세어봤어요. 폴더 두 개를 합쳐 문서 20,..

공부/인공지능 2026.08.02

[세컨드브레인 개발기] 1. 개인 세컨드브레인을 RAG 없이 시작한 이유

[세컨드브레인 개발기] 1. 개인 세컨드브레인을 RAG 없이 시작한 이유의료영상 AI 연구를 하다 보니, 논문이며 회의록, 연구계획서, 강의자료, 과제 문서가 몇 년치 쌓였는데, 어느 순간부터는 어디에 뭐가 있는지 내 머리로 감당이 안 되기 시작했습니다. 검색을 해도 파일명이 기억나야 찾아지고, 파일명은 당연히 기억나지 않고요. 그래서 개인 연구용 세컨드브레인을 만들기로 했습니다. 2026년 6월 2일이었어요. 이 글은 그 첫날에 내린 설계 결정 하나에 관한 이야기입니다. 요즘 이런 걸 만든다고 하면 거의 자동으로 나오는 답이 있는데, 문서를 청크로 쪼개 임베딩하고 벡터DB에 넣어두고, 질문이 들어오면 비슷한 조각을 꺼내 LLM에 물리는 방식, 그러니까 RAG입니다. 나는 그걸 안 하기로 시작했습니다. ..

공부/인공지능 2026.08.02