[세컨드브레인 개발기] 1. 개인 세컨드브레인을 RAG 없이 시작한 이유
의료영상 AI 연구를 하다 보니, 논문이며 회의록, 연구계획서, 강의자료, 과제 문서가 몇 년치 쌓였는데, 어느 순간부터는 어디에 뭐가 있는지 내 머리로 감당이 안 되기 시작했습니다. 검색을 해도 파일명이 기억나야 찾아지고, 파일명은 당연히 기억나지 않고요.
그래서 개인 연구용 세컨드브레인을 만들기로 했습니다. 2026년 6월 2일이었어요.
이 글은 그 첫날에 내린 설계 결정 하나에 관한 이야기입니다. 요즘 이런 걸 만든다고 하면 거의 자동으로 나오는 답이 있는데, 문서를 청크로 쪼개 임베딩하고 벡터DB에 넣어두고, 질문이 들어오면 비슷한 조각을 꺼내 LLM에 물리는 방식, 그러니까 RAG입니다. 나는 그걸 안 하기로 시작했습니다.
두 달 뒤에 이 시스템은 "아무짝에도 쓸모없다"는 말을 듣게 되는데, 미리 밝혀두면 그 원인은 이 결정이 아니었습니다. 그래도 첫날의 판단부터 적어두는 게 맞다고 생각해요. 나중에 무너지는 게 정확히 어느 층이었는지 가려내려면, 출발점이 남아 있어야 하니까.
대신 고른 것 — 질의 시점이 아니라 수집 시점에 합성한다
Karpathy가 정리한 LLM-Wiki 패턴을 택했습니다. 골자는 LLM이 도는 시점을 앞으로 당기는 것입니다.
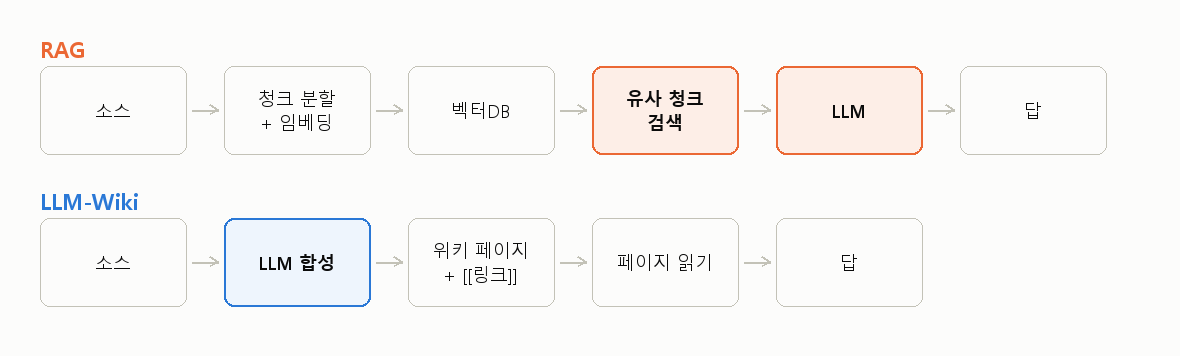
RAG는 소스를 원본 그대로 두고, 질문이 올 때마다 조각을 찾아 조립합니다. LLM-Wiki는 반대로, 소스가 들어오는 그 시점에 LLM이 한 번 읽고 마크다운 페이지로 다시 쓰면서, 다른 페이지로 갈 링크를 본문에 박아 넣어요. 그러면 질문이 들어와도 검색해서 조립할 필요 없이, 이미 정리돼 있는 글을 읽으면 됩니다.
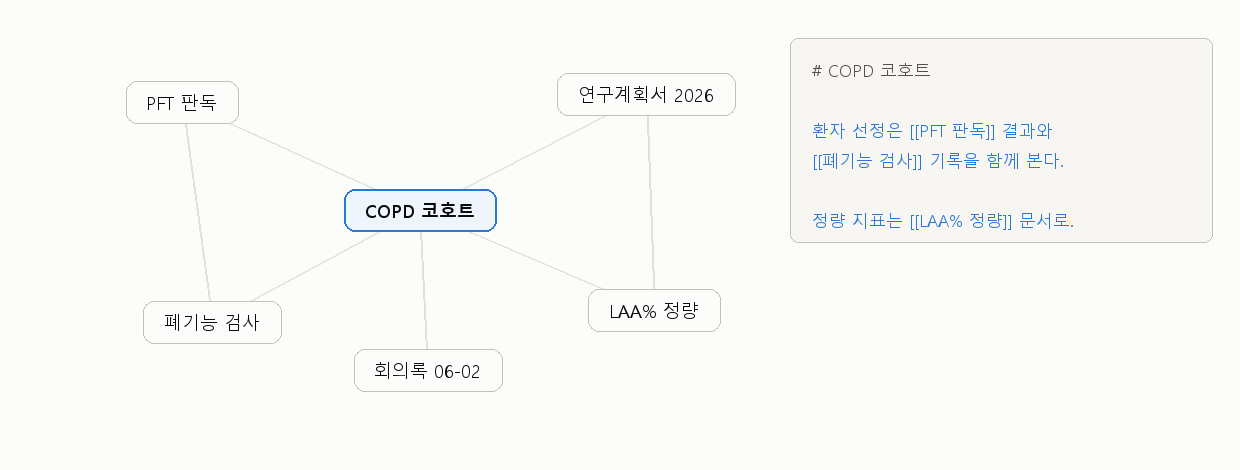
이 구조에서는 질의 시점에 임베딩이 아예 필요 없습니다. 사람이 읽을 수 있는 위키가 이미 만들어져 있고, 페이지끼리 링크로 엮여 있는데, Obsidian의 위키링크 문법을 그대로 썼으니 그 링크 집합이 곧 지식 그래프가 됩니다. 그래프DB를 따로 둘 이유가 없었어요. v1에는 벡터DB도 그래프DB도 넣지 않았고, 그건 빠뜨린 게 아니라 결정이었습니다.
근거가 세 가지였습니다.
하나, 개인 규모에서는 사전합성이 RAG를 이깁니다. 소스가 수백에서 수천 개 수준이라면, 전부 한 번씩 읽고 정리해두는 비용을 감당할 수 있고, 그러면 질의 시점에는 잘 정리된 글을 읽는 셈이니 답 품질이 조각 검색보다 낫습니다. 조각 검색의 약점이 꽤 분명해서 그렇게 봤어요. 청크는 문서를 기계적으로 자른 것이라, 잘린 자리에서 문맥이 끊기고, 표의 헤더와 값이 서로 다른 청크로 갈라지고, 앞 문단을 알아야 뜻이 통하는 문장이 혼자 떨어져 나옵니다. 미리 사람이 읽을 글로 다시 써두면 그런 일이 애초에 생기지 않습니다. 회사 문서 수십만 건이라면 얘기가 다르겠지만, 내 자료는 그 규모가 아니라고 봤습니다.
둘, 무거운 GraphRAG는 비용 대비 이득이 얇습니다. 개인 메모리 계층을 다루는 쪽(Mem0, PersonalAI)의 보고를 보면, 본격적인 GraphRAG는 2~3배 비용을 쓰면서 이득은 생각보다 작습니다. 링크로 엮인 마크다운이 이미 그래프의 90%를 준다면, 남은 10%에 3배를 쓸 이유가 없었어요. 게다가 마크다운 링크에는 공짜로 따라오는 게 하나 있는데, 사람이 브라우저로 눌러서 돌아다닐 수 있다는 점입니다. 그래프DB 안의 간선은 쿼리를 써야 보이지만, 위키링크는 그냥 클릭됩니다.
셋, 그리고 이게 사실 제일 컸는데 — 벡터DB를 올릴 자리가 없었습니다.
하드웨어가 설계를 정했다
서빙 박스는 과제비로 구매한 MSI EdgeXpert입니다. NVIDIA GB10 Grace-Blackwell을 얹은 물건인데, 솔직히 말하면 DGX Spark의 아류작 혹은 짭퉁이에요. 그래도 같은 스펙에 가격이 조금 낮으면, 그깟 금색 커버 아닌들 어떠하리. 책상 위에 놓인 이 네모박스가 은근히 주는 만족감이 아주 큽니다.
당시 실측 스펙은 이렇습니다.
통합메모리     약 128GB (가용 121GB)
CPU           ARM64 20코어
디스크         916GB
LLM           NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4
서빙           vLLM, 256K 컨텍스트, OpenAI 호환 API
통합메모리 박스는 CPU와 GPU가 같은 메모리를 나눠 씁니다. 120B급을 단일 박스에 올릴 수 있다는 게 이 구성을 고른 이유였지만, 대신 모델이 올라가면 나머지 전부가 그 뒤에 줄을 서게 됩니다. 별도 VRAM이 있는 구성이라면 벡터DB는 시스템 RAM에 살면 되니 모델과 자리를 다투지 않는데, 통합메모리에서는 그런 구분이 없어서 모델이 먹은 만큼이 그냥 사라집니다.
vLLM을 기본 설정으로 띄웠더니, 가용 121GB 중 119GB 가량을 먹고 2GB대가 남았습니다.
여기에 Qdrant를 띄우고 임베딩 모델까지 상주시킨다는 계획은, 계획이 아니라 농담입니다. 상주시켜야 한다는 조건도 중요한데, 임베딩 모델은 로드 자체가 오래 걸려서, 검색 한 번 하려고 매번 올렸다 내리는 구조로는 쓸 수가 없습니다. 결국 벡터 검색을 붙이려면 메모리에 계속 앉아 있는 프로세스를 하나 더 둬야 하는데, 그 자리가 없었습니다.
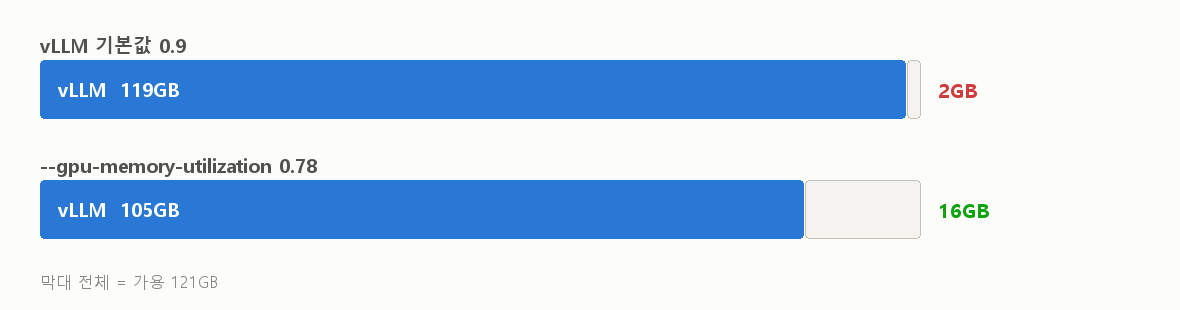
제약은 나중에 조금 풀었습니다. vLLM 컨테이너를 --gpu-memory-utilization 0.78로 다시 만들어서 14GB 가량을 회수했고(기본값이 0.9였습니다), 그 뒤로 가용 RAM이 16GiB 정도 됐습니다. 다만 그건 나중 일이고, 첫날의 판단 기준은 "여유가 없다"였습니다.
그러니까 벡터DB 없는 설계는 이론적 선호이기도 했지만, 하드웨어가 시킨 것이기도 했습니다. 이건 미리 밝혀두는 편이 정직하다고 생각합니다. 제약 때문에 어쩔 수 없이 고른 걸 나중에 소신처럼 적어두면, 다시 읽을 때 그 판단의 진짜 근거를 알 수 없게 되니까요.
첫날 돌아간 것
명령 여섯 개짜리 CLI로 만들었습니다.
brain init      저장소 초기화
brain ingest    새 소스를 LLM이 읽고 위키 페이지로 합성
brain query     위키에서 찾아 답한다
brain lint      죽은 링크·빈 페이지 점검
brain digest    최근 변화 요약
brain status    상태
여기에 웹 리서치를 하나 더 붙였는데, brain ask는 자체 호스팅한 SearXNG를 물고 ReAct 루프를 돌려서, 브레인 안에 없는 걸 물으면 웹에서 찾아옵니다. 검색엔진을 직접 띄운 건 API 키와 쿼터에 묶이지 않으려는 것이었어요. 개인 도구가 남의 요금제 위에 서 있으면, 어느 날 조용히 멈춰 버립니다.
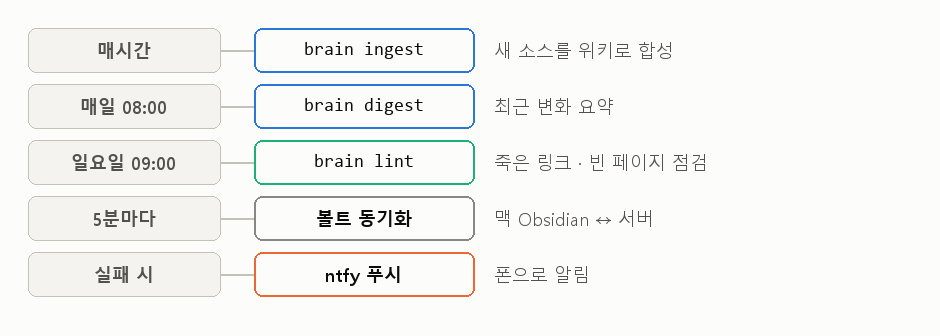
자동화도 첫날 걸었습니다. 서버 크론으로 매시간 ingest, 아침 8시 다이제스트, 일요일 9시 lint를 돌리고, 맥에서는 Obsidian 볼트를 5분마다 동기화했습니다. 실패하면 폰으로 푸시가 오도록 ntfy를 붙였고, 6월 2일에 여기까지 엔드투엔드로 돌아가는 걸 확인했습니다.
기분이 좋았습니다. 설계가 깔끔했고, 벡터DB 없이도 된다는 걸 증명한 것 같았고, 링크로 엮인 위키가 실제로 브라우징까지 됐고요.
lint 가 존재할 수 있다는 것
이 설계에서 내가 제일 마음에 들어했던 건, 명령 목록의 네 번째 줄이었습니다. brain lint가 존재할 수 있다는 점.
위키가 링크로 엮인 마크다운이니 점검이 그냥 가능합니다. 없는 페이지를 가리키는 링크를 세면 죽은 링크가 나오고, 본문이 비었거나 제목만 있는 페이지도 셀 수 있고, 아무 데서도 링크되지 않은 고아 페이지까지 찾아낼 수 있어요. 전부 파일과 문자열을 세는 일이라 특별한 도구가 필요 없어서, 일요일 아침마다 걸어둘 수 있었습니다.
벡터DB에는 이에 해당하는 게 없습니다. 임베딩이 제대로 됐는지 확인하는 표준 점검이라는 게 없어서, 색인이 몇 개인지는 세어도 그 벡터들이 의미 있는 자리에 놓였는지는 세어서 알 수가 없어요. 검색 결과가 이상해 보여도, 원래 이 정도인지 망가진 것인지 구별할 기준이 없습니다.
이 차이가 사전합성 방식의 저평가된 실질적 이점이라고 생각합니다. 사람이 읽을 수 있는 산출물은 검증도 사람이 할 수 있습니다. 위키 페이지가 엉뚱하게 쓰여 있으면 열어보면 보이는데, 벡터가 엉뚱한 자리에 있으면 열어볼 방법이 없습니다.
경험이 있어서 그렇게 말하는 건데, 벡터 쪽이 티 안 나게 망가지는 걸 나중에 몇 주 동안 모른 채로 겪습니다. 그때 증상은 "검색이 안 된다"가 아니라 "답이 그럴듯한데 틀렸다"였고, 그게 훨씬 나쁩니다.
그래서, 이 결정은 틀렸나
아닙니다. 지금도 개인 규모에서는 사전합성이 맞다고 생각합니다. 이 시리즈 후반에서 무너지는 건 이 결정이 아니라 여기에 급하게 덧붙인 층이고, 둘은 서로 모순되지 않습니다.
문제는 다른 데 있었습니다. 위에서 근거를 적을 때, 나는 이렇게 썼습니다.
개인 규모(소스 수백~수천 개)에서는 사전합성이 RAG를 이깁니다.
괄호 안이 조건인데, 나는 그걸 근거 문단에만 적고, 설계 문서 어디에도 "이 설계는 소스 N개까지 유효하다"고 적지 않았습니다. 조건부 명제를 무조건 명제처럼 저장해둔 셈입니다.
사소해 보이지만 사소하지 않습니다. 조건을 적어두면 그 조건을 감시할 수 있어서, 소스 개수가 임계값에 가까워질 때 알림을 걸 수도 있고, 적어도 다음에 이 문서를 읽는 사람이 "지금 몇 개인데?" 하고 물을 수 있습니다. 조건을 지우고 결론만 남기면, 언제 만료되는지 알 수 없는 문장이 되어 버립니다.
그리고 같은 날 오후에, 그 조건이 깨졌습니다. 문서 2만 개를 만났어요.
다음 편에서 그 이야기를 써 보겠습니다.
'공부 > 인공지능' 카테고리의 다른 글
| [세컨드브레인 개발기] 6. 소리가 줄어드는 녹음. (0) | 2026.08.05 |
|---|---|
| [세컨드브레인 개발기] 5. 끊기지 않는 유입. (0) | 2026.08.03 |
| [세컨드브레인 개발기] 4. 위키가 영어로 쓰여 있었다 — 4,382개 중 482개 (0) | 2026.08.02 |
| [세컨드브레인 개발기] 3. 20k 문서를 실제로 읽어들이기 — 로더 지옥 (0) | 2026.08.02 |
| [세컨드브레인 개발기] 2. 20,000개 문서 앞에서 설계가 무너진 날 (0) | 2026.08.02 |