vllm 3

게이트를 만들었다가 걷어냈다 — 로컬 LLM 멈춤의 진짜 원인 찾기

게이트를 만들었다가 걷어냈다 — 로컬 LLM 멈춤의 진짜 원인 찾기 컨텍스트가 큰 로컬 LLM을 여러 세션으로 나눠 쓰다 보면, 세션을 셋째 개 열 때쯤 전체 요청이 뻗어버리는 일이 반복됐습니다. 대부분의 운영 이야기에서 이 시점의 결론은 하나로 정해져 있습니다. 「KV 캐시가 부족해서 그렇다」는 것. 저도 그랬습니다. 하지만 이번에는 그 결론이 틀렸습니다. 그래서 원인을 고치겠다고 게이트웨이를 먼저 만들었고, 한참을 돌고 나서 그 게이트를 통째로 걷어냈습니다. 만들었다가 지운, 그 과정과 이유를 적어봅니다.증상과 오진: 「컨텍스트를 줄이자」가 아니라 「접수 창구를 만들자」멈춤 현상은 이렇게 옵니다. 한두 개 세션은 거뜬히 돌아가는데, 세 번째 세션에 요청이 들어오면 전체가 미적대다가 폴백 모델로 떨어집..
공부/인공지능 2026.10.05

27B 로컬 LLM을 vLLM → llama.cpp로 갈아끼우며 동시성·속도 끌어올리기

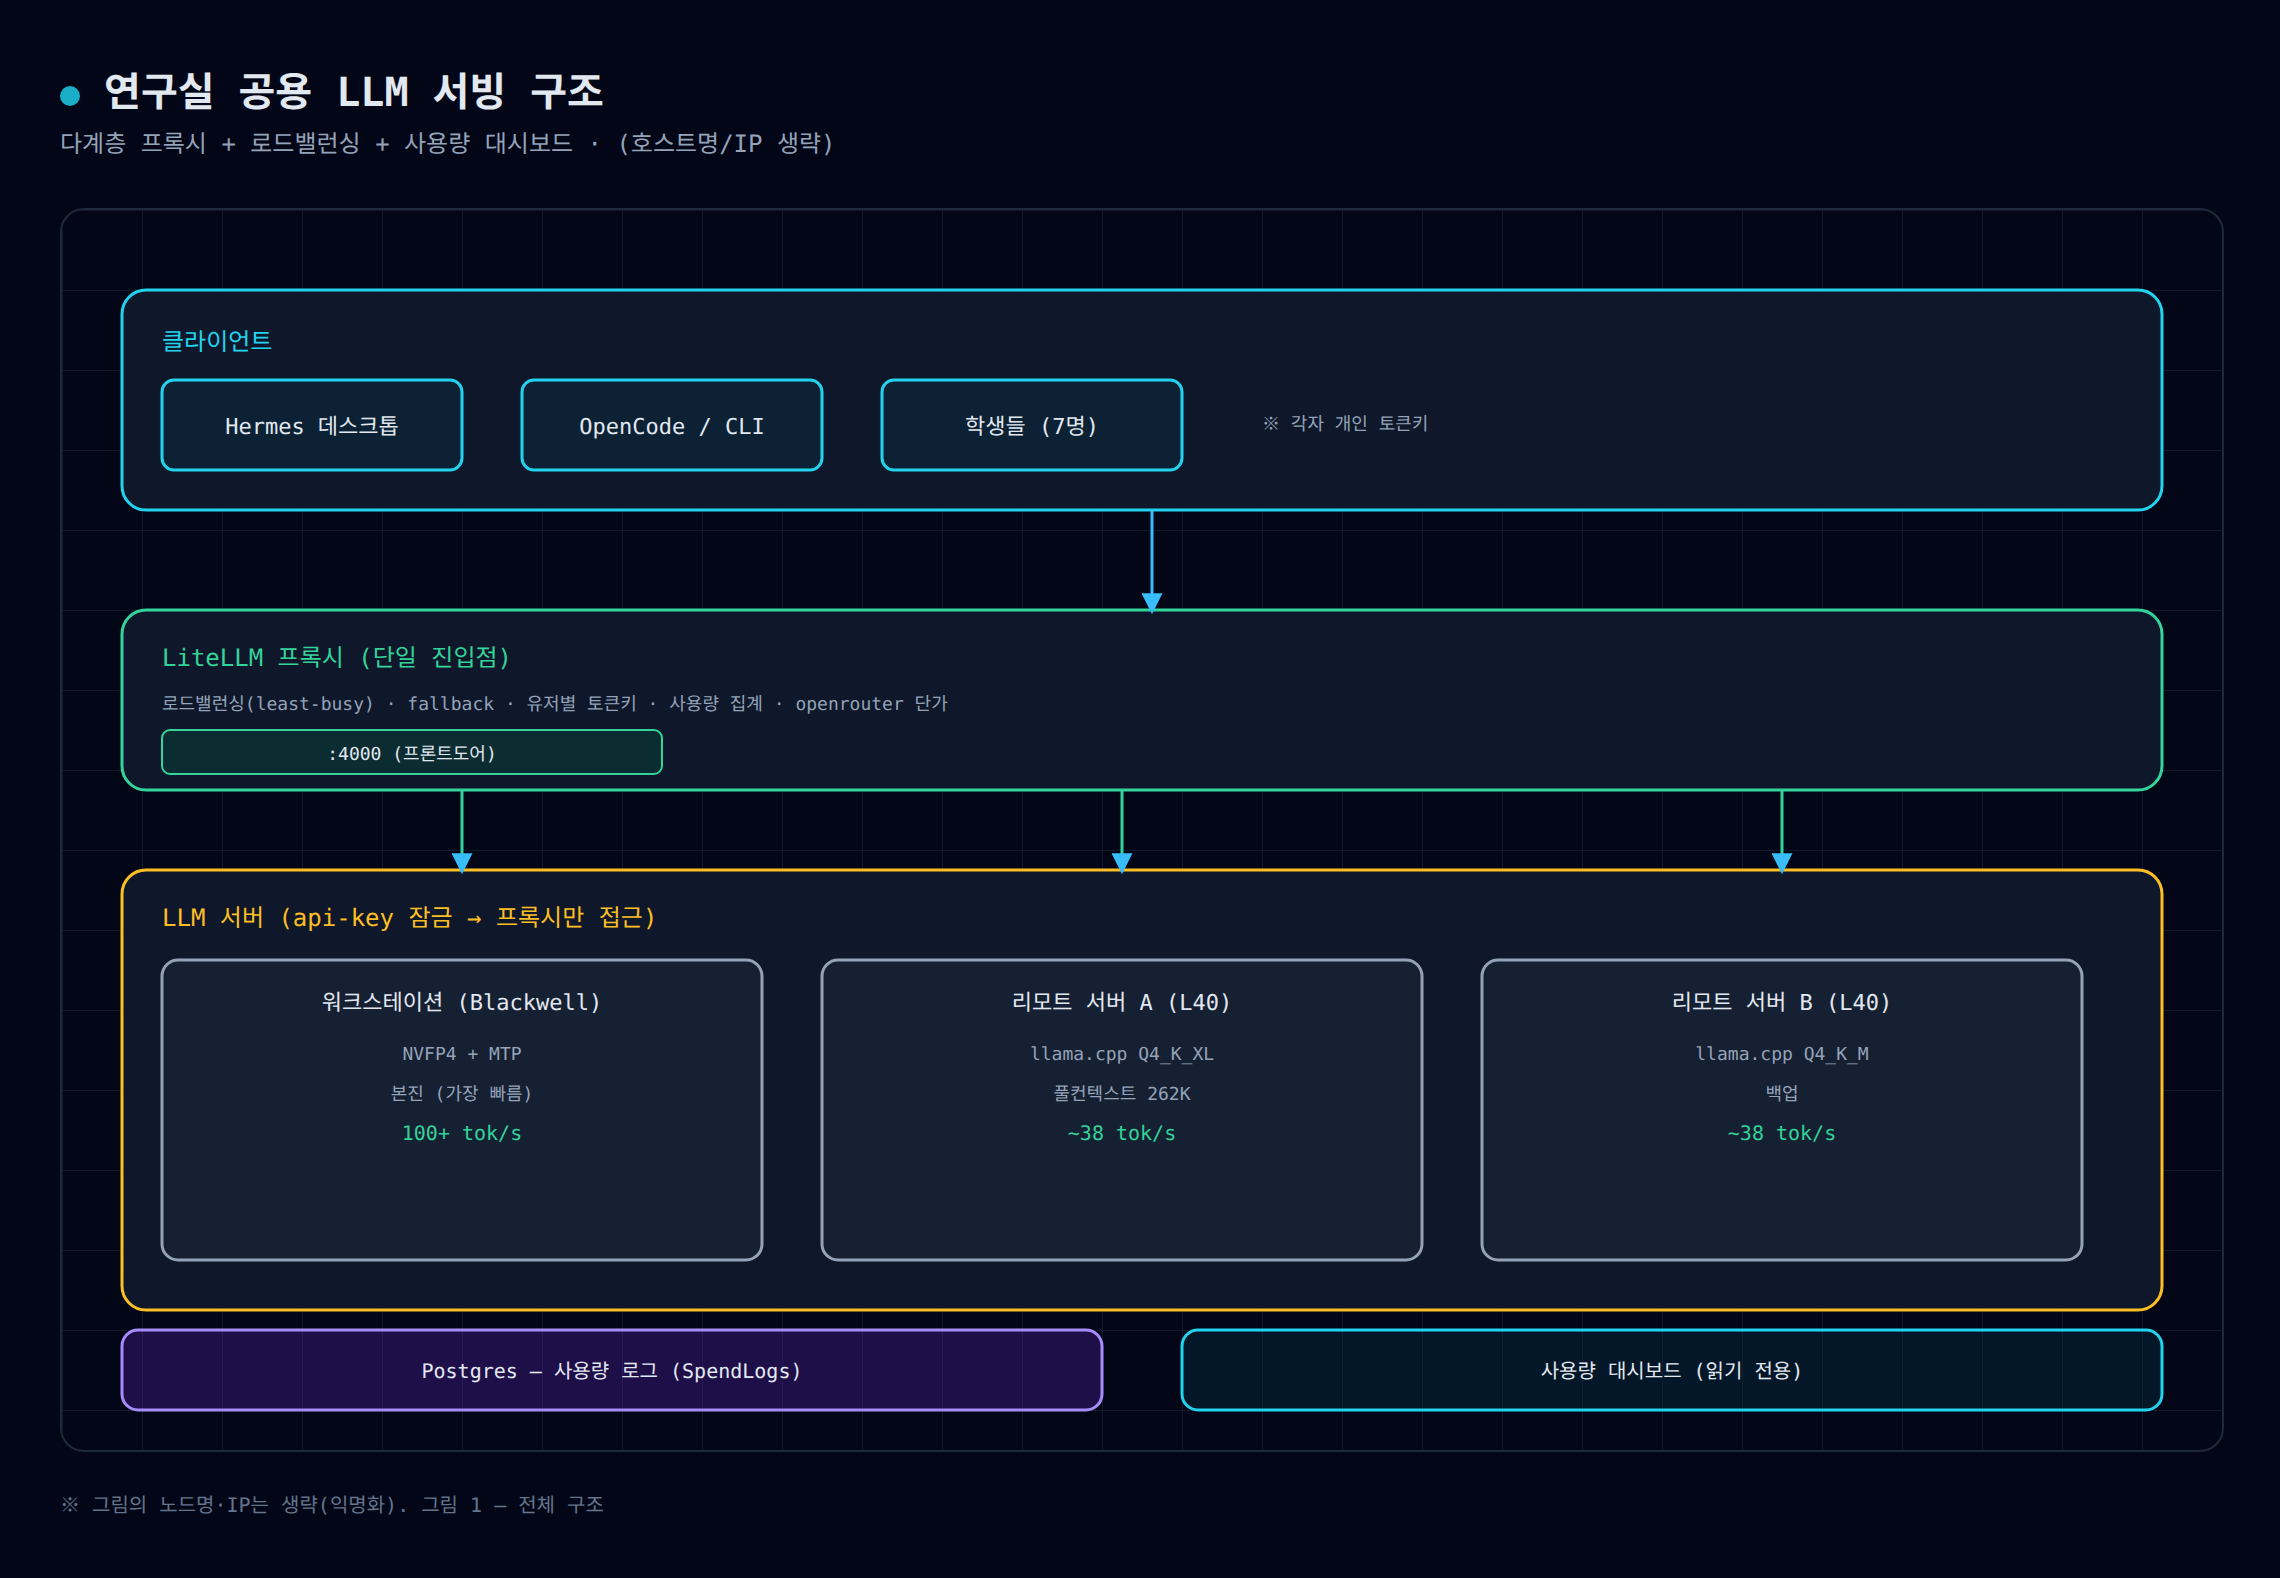
연구실에 공용 LLM 서버를 돌리면서 생긴 일입니다. 27B짜리 dense(hybrid linear-attn) 모델을 워크스테이션과 리모트 서버에 올려서, 교수와 학생 7명이 매일같이 붙들고 썼는데, 문제가 하나 있었습니다. vLLM으로 FP8 양자화를 걸면 안정적이긴 한데 응답 속도가 아쉽고, 요청이 몰리면 속도가 급격히 떨어졌습니다. 그래서 저는 하드웨어를 더 사는 대신, 서빙 레이어만 통째로 바꾸는 쪽을 택했습니다. 왜 갈아탔나 — vLLM의 벽vLLM은 정말 잘 만들었습니다. 다만 이 모델이 hybrid linear-attention 구조라서, 카드 세 장을 TP=3으로 한 덩어리로 묶는 게 애초에 안 됩니다. "16 not divisible by 3"이라는 에러가 뜨면서 죽네요. 그래서 TP=2..

공부/인공지능 2026.09.09

[세컨드브레인 개발기] 16. 122B와 27B — 커도, 빠른 것도 다 이긴 건 아니었다

[세컨드브레인 개발기] 16. 122B와 27B — 커도, 빠른 것도 다 이긴 건 아니었다15편 마지막에 122B 모델로 갈아탔습니다. 큰 모델로 바꾸면 다 나아질 거라 믿었죠. 그런데 직접 비교해 보니, 더 큰 모델이 이긴 건 속도뿐이었습니다. 지능은 아니었어요. 이 머신에는 사실 두 개의 후보가 있었는데, 크기로 보면 122B, 품질로 보면 27B였습니다. 그 둘을 이 머신에서 실제로 재보고 정리한 이야기입니다.올리고 나서 좋은 말만 적어뒀다 122B를 올리던 시절의 기록에는 좋은 말만 가득합니다. 모델 항목에는 "122B는 훨씬 똑똑함", 품질에는 "프런티어급"이라고 적혀 있고, 속도는 85~90 tok/s로 목표였던 81을 넉넉히 넘겼습니다. 컨텍스트도 256K로 늘었어요. 기록만 읽으면 이 머신..

공부/인공지능 2026.08.26