[세컨드브레인 개발기] 16. 122B와 27B — 커도, 빠른 것도 다 이긴 건 아니었다
15편 마지막에 122B 모델로 갈아탔습니다. 큰 모델로 바꾸면 다 나아질 거라 믿었죠. 그런데 직접 비교해 보니, 더 큰 모델이 이긴 건 속도뿐이었습니다. 지능은 아니었어요. 이 머신에는 사실 두 개의 후보가 있었는데, 크기로 보면 122B, 품질로 보면 27B였습니다. 그 둘을 이 머신에서 실제로 재보고 정리한 이야기입니다.
올리고 나서 좋은 말만 적어뒀다
122B를 올리던 시절의 기록에는 좋은 말만 가득합니다. 모델 항목에는 "122B는 훨씬 똑똑함", 품질에는 "프런티어급"이라고 적혀 있고, 속도는 85~90 tok/s로 목표였던 81을 넉넉히 넘겼습니다. 컨텍스트도 256K로 늘었어요. 기록만 읽으면 이 머신이 완벽한 선택을 한 것처럼 보입니다.
어느 것 하나 틀린 말은 아니었습니다. 숫자도 사실이었어요. 문제는 그 숫자들이 항상 나오는 값이 아니었다는 것, 그리고 "훨씬 똑똑함"이라는 결론이 실측과 어긋났다는 것입니다. 사실관계가 틀린 게 아니라, 비교를 빠뜨린 채 결론을 적어둔 것이었죠.
속도는 베스트케이스였다
81 tok/s라는 숫자는 07-25 기록에서 나왔습니다. 당시엔 기존 29 tok/s 대비 2.8배 향상이라며 남겼고, 15편에도 실었어요. 그런데 이 숫자는 조건이 갖춰질 때만 나옵니다. 워밍업이 끝나고, 단일 요청이고, 영어 텍스트를 처리하고, 스펙디코딩 수용률이 높아야 해요. 일상에서 만나는 입력은 거의 그 조건이 아니었습니다.
한국어 회의록을 올리면 15 tok/s로 떨어졌습니다. 같은 모델, 같은 머신인데 언어만 한글로 바뀌었을 뿐인데도 세 배나 느려진 것이죠. 사람으로 치면, 같은 업무인데 상대가 한국어를 쓰면 갑자기 일이 서너 배로 느려지는 상황이나 마찬가지였습니다.
측정에는 주의가 하나 더 필요합니다. 첫 요청은 커널 JIT 컴파일 때문에 비정상적으로 느려요. 122B가 3.6 tok/s로 찍힌 게 그 경우입니다. 그래서 측정은 반드시 워밍업을 한 뒤에 해야 합니다. 뒤에 스펙디코딩 토큰 수를 6에서 3으로 줄이고 어텐션 백엔드를 바꾸니 28~29 tok/s까지 올라갔지만, 여전히 영어의 절반 수준이었습니다. 조건별 실측을 붙여두면 이렇습니다.

| 조건 | 속도 |
|---|---|
| 한국어 산문 · 튜닝 전 | 15 tok/s |
| 한국어 산문 · 스펙 6→3 + FLASHINFER | 28~29 tok/s |
| 256K 컨텍스트 실측 | 41.8 tok/s |
| 영어 트래픽 · 단일 스트림 | 81~90 tok/s |
지능 비교는 표가 말해준다
속도만으로 모델을 고를 수는 없어서, 지능도 직접 비교했습니다. 07-25 실측 세션이 벤치마크의 원본이고, 결과는 표 하나로 정리했어요.
| 항목 | 122B-A10B | 27B |
|---|---|---|
| 연구 방법론 비평 | 외부검증·진단유효성 지적 | 더 예리 — 교란변수(연령·성별·흡연력) 미통제 지적 |
| 정량 임상추론 (PPV) | 44.3%/12.2% 완벽 | 동일하게 완벽 |
| 롱테일 지식 | IEC 62985를 "전기차 충전"이라 환각 (Dice↔IoU는 정답) | 모르면 모름이라 정직 (Dice 역변환은 오답) |
| 비전 | 도형·색·글자·표 정확 | 동일하게 정확 |
| 표 숫자 판독 | 100% | 100% |
| 컨텍스트 | 262,144 | 262,144 (동일) |
| 속도 (코드/산문) | 41.8 / 36.5 tok/s | 29.4 tok/s |
결과는 단순했습니다. 정량적인 일은 둘 다 완벽하게 해냈고, 비전과 컨텍스트도 동일했어요. 차이가 갈린 건 두 군데였습니다. 하나는 논문을 비평하는 일에서 27B가 더 예리했다는 것이고, 다른 하나는 롱테일 지식에서 122B가 모르는 걸 지어냈다는 것입니다. IEC 62985라는 CT 선량 관련 표준을 "전기차 충전 표준"이라고 답한 것이죠. 모르면 모른다고 하는 것보다, 아는 척 지어내는 것이 더 나쁘다는 걸 그때 다시 느꼈습니다. 27B도 완벽하진 않아서 Dice와 IoU를 뒤집는 계산은 틀렸지만, "이건 모르겠다"고 말하는 태도가 훨씬 다루기 좋았습니다.
그래서 당시 장부에는 "모델 자체 품질은 27B가 위"라고 남겼습니다. 122B는 더 나은 모델이 아니라, GB10 저대역폭이라는 조건에서 돌릴 수 있는 최선의 선택이었어요. 이 문장이 이 편의 결론이기도 합니다.
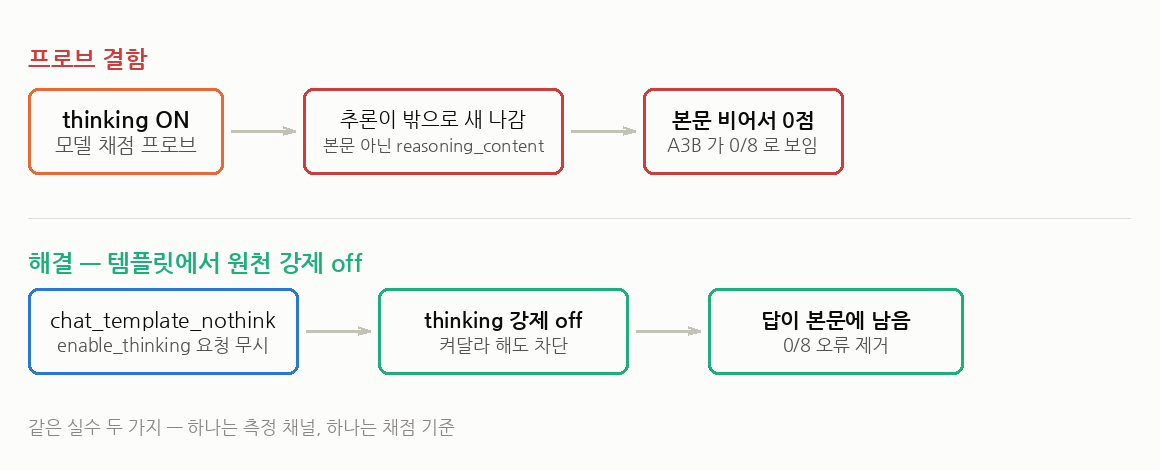
이 비교가 항상 깨끗하게 나온 것은 아니었습니다. 측정을 두 번 틀렸기 때문이에요. 한 번은 채점용 프로브에 thinking이 켜져 있었습니다. thinking이 켜지면 모델은 추론 과정을 본문이 아니라 reasoning_content로 보내요. 프로브는 본문만 읽었으니, 추론은 다른 곳으로 빠지고 본문은 비어서 0점이 나왔습니다. A3B가 0/8로 보인 것이 바로 그 상태였죠. 두 모델을 같은 조건에서 다시 재니 제대로 점수가 나왔습니다.
또 한 번은 정규식으로 채점하다가 틀린 답을 맞다고 통과시킨 일입니다. 채점 도구가 틀리면 결론이 통째로 뒤집혀요. 지능 비교를 믿기 전에, 그 비교에 쓴 줄자부터 의심해야 한다는 걸 이번에 배웠습니다.
측정하면서 고친 오해가 하나 더 있었습니다. 처음에 27B는 텍스트 전용이라 생각했어요. gpugeant 머신에 따로 비전 모델이 떠 있길래 그렇게 짐작한 것인데, 찾아보니 27B 설정에 vision_config가 있었고 실제 이미지를 보내면 정확히 판독했습니다. 27B도 멀티모달이었죠. 122B가 이긴다고 믿었던 항목 중 하나가 여기서도 지워졌습니다.
GB10의 역설
그럼 왜 122B를 올렸나. 여기에 하드웨어가 만든 역설이 있습니다. 같은 27B 모델을 두 머신에서 돌리면 결과가 갈려요. 대역폭이 273GB/s인 GB10에서는 27B가 11~15 tok/s로 처집니다. 주력으로 쓰기 어려운 속도죠. 그런데 대역폭이 넉넉한 L40 머신에서는 같은 모델이 29.4 tok/s를 냅니다. 모델은 같은데, 돌리는 하드웨어에 따라 쓸 수 있느냐 없느냐가 갈리는 것입니다.
속도는 대역폭을 활성 파라미터와 바이트로 나눈 값입니다. 27B는 토큰당 활성 파라미터가 27B 전부예요. 122B는 총 파라미터는 122B지만 토큰당 활성은 10B입니다. 좁은 대역폭의 GB10에서는 읽는 양이 적은 쪽이 이깁니다. 그래서 122B가 41.8 tok/s로 빠른 것이죠.
122B 채택은 품질 때문이 아니라 대역폭 때문입니다. 이게 이번 비교의 가장 큰 결론이에요. 크다고 좋은 게 아니라, 좁은 대역폭에서 버틸 수 있는 구조가 필요한 것입니다.
지금은 어떤 모델이 일하고 있나
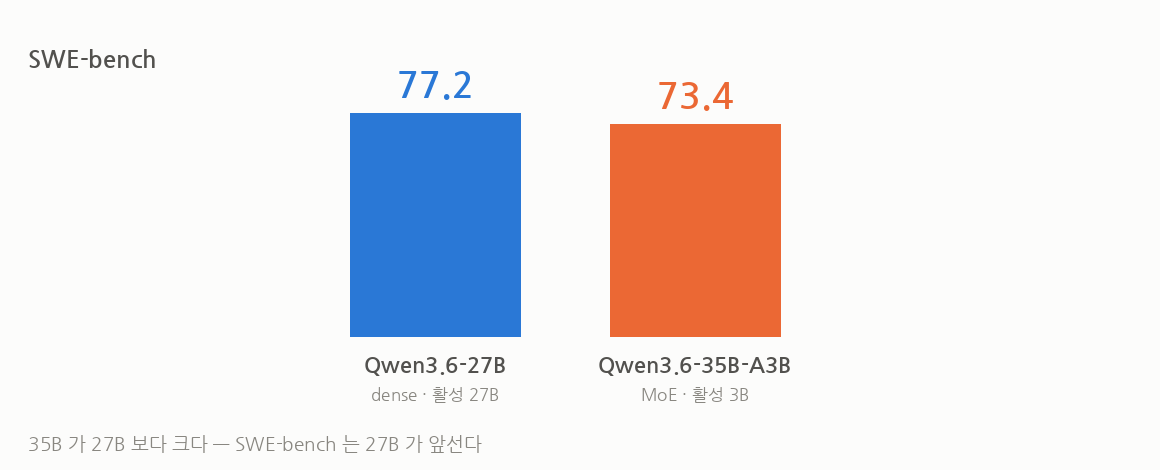
2026-08 서빙 구성을 보면, 122B는 운용 중단으로 적혀 있습니다. 주력 자리는 deepseek-v4-flash가 채웠고, 27B는 gpu-remote-01로 옮겨서 일하고 있어요.
122B를 내린 데는 느린 것 외에도 이유가 있었습니다. 유휴 상태였다가 첫 요청이 들어오면 96초를 기다려야 했어요. 1분 반을 화면 앞에서 기다리는 일은 실사용에서 견디기 어렵습니다. 게다가 동시 요청이 몰리면 처리량이 반토막이 났고, keepalive 핑을 보내야 겨우 살아 있었죠. 속도가 빠른 모델이어도, 쓰는 쪽이 불안하면 주력이 되기 어렵습니다.
큰 모델에 건 기대는, 크면 다 잘할 거라는 믿음이었습니다. 비교 결과는 달랐어요. 지능은 27B가 나았고, 122B는 대역폭이라는 제약에 답한 모델이었습니다. 크면 좋을 거라는 믿음은, 직접 재보기 전까지는 믿음일 뿐이에요.
'공부 > 인공지능' 카테고리의 다른 글
| 게임 스프라이트를 로컬 Wan 2.2로 뽑아봤다. (핑크팬더 5모션) (0) | 2026.08.28 |
|---|---|
| DGX Spark 2대, 1M 컨텍스트 도전기. (Qwen3.8-Flash-Next day-0) (0) | 2026.08.28 |
| [세컨드브레인 개발기] 15. 주력 모델이 3번 바뀌었다. 사유도 각각 달랐다. (0) | 2026.08.18 |
| [세컨드브레인 개발기] 14. GB10 에서 배운 것 — 속도는 대역폭을 활성 파라미터로 나눈 값이다 (0) | 2026.08.16 |
| AI 직원 11명 고용기. (0) | 2026.08.14 |