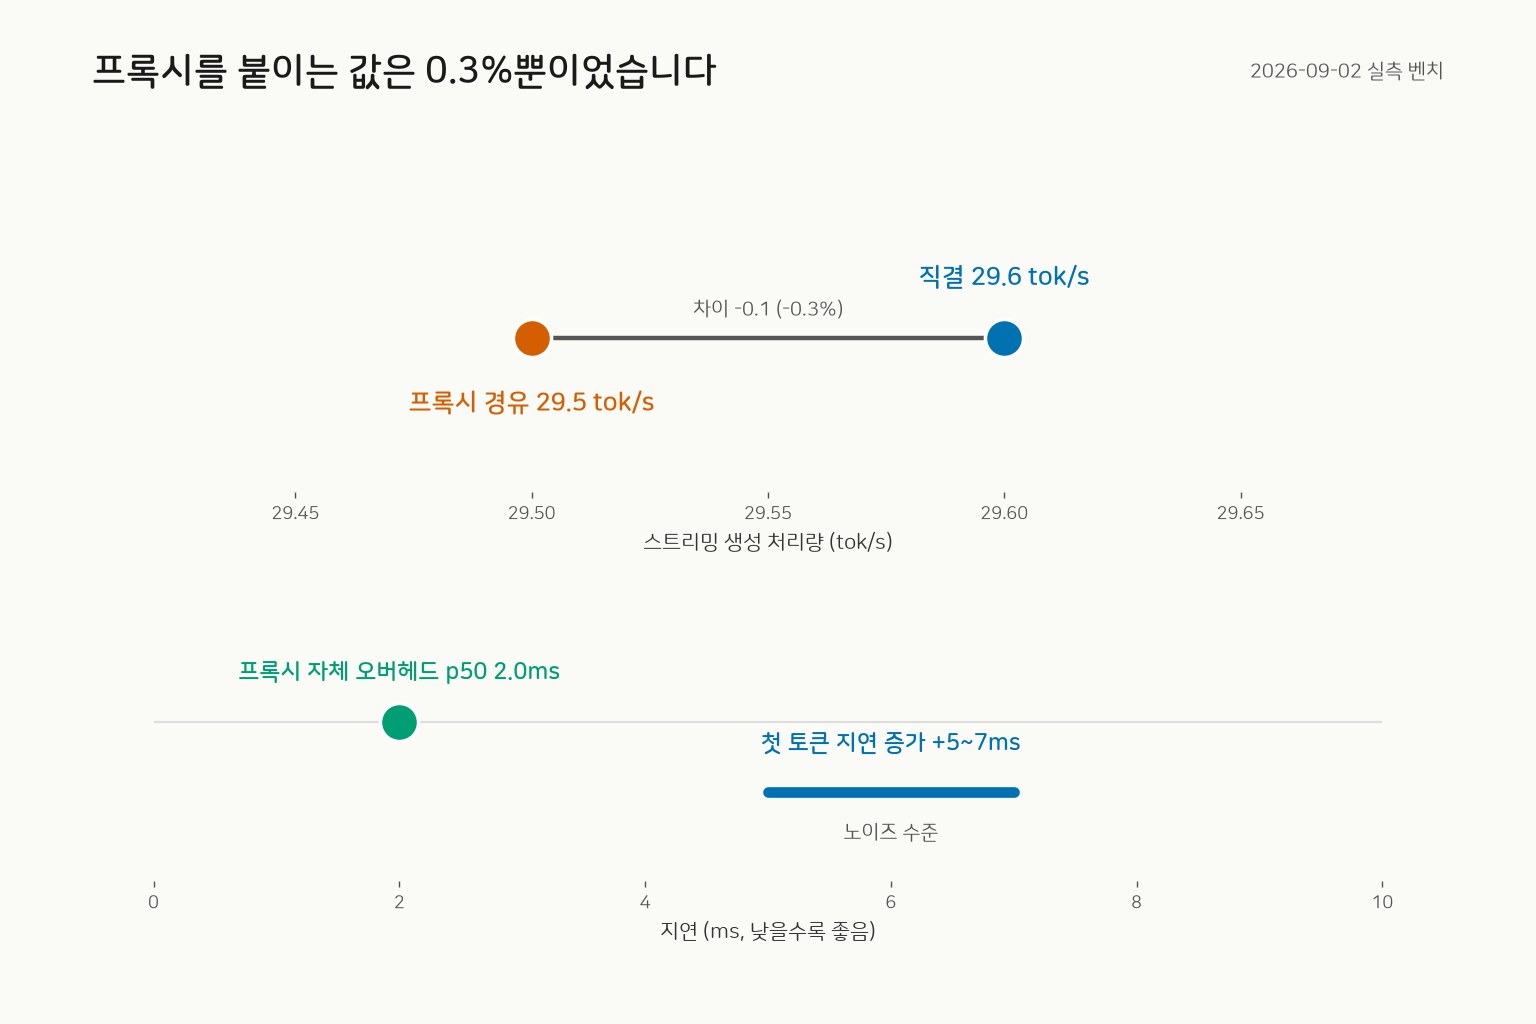

처리량이 0.3%밖에 안 떨어졌습니다. 프록시를 붙이는 대가가 그 정도라고 생각했죠. 아닌 게 정답에 가까웠습니다. 0.3%는 거의 공짜였고, 진짜 어렵기는 뒤에서 생긴 세 가지였습니다. 연구실에서 모델을 쓰는 사람들마다 키를 나눠 주고, 누가 얼마를 썼는지 집계하고 싶어졌습니다. vLLM이 기본으로 가진 멀티 키는 인증만 되고 토큰 사용 로그가 남지 않아서, 집계를 하려면 한복판에 프록시를 하나 세워야 했습니다. 붙이기 전 벤치는 선명했습니다. 같은 스트리밍 생성을 직결로 돌리면 29.6 tok/s, 프록시 경유로 돌리면 29.5 tok/s였습니다. 첫 토큰까지 걸리는 시간은 5~7ms 늘었고, 프록시 자체 오버헤드는 응답 헤더로 재니 p50 2.0ms였습니다. 노이즈 수준이라서 그냥 붙였습니다. 0...