실시간 음성대화 모드로 음성비서를 굴리고 있는데(그 음성 지연 병목을 뜯었던 글은 여기 있습니다), 아주 상식적인 질문이 하나 떠올랐습니다. 비전용 mmproj 어댑터는 그렇게 잘 붙는데, 오디오도 붙이면 STT 서버 단계를 통째로 줄일 수 있지 않을까요. 그래서 로컬 27B의 웨이트를 직접 열어봤습니다.
config.json이 정직했습니다
할 일은 단순했습니다. 허브에서 config.json을 받아 키 목록을 본 것뿐입니다. 오늘 직접 curl로 실측한 결과입니다.
curl -s https://huggingface.co/Qwen/Qwen3.8-27B/resolve/main/config.json | jq 'keys'
["architectures", "image_token_id", "language_model_only", "model_type",
 "text_config", "tie_word_embeddings", "transformers_version",
 "video_token_id", "vision_config", "vision_end_token_id",
 "vision_start_token_id"]
키가 열한 개입니다. 이 중 네 개(vision_config, vision_start_token_id, vision_end_token_id, image_token_id)가 비전용이고, 오디오 관련 키는 0개입니다. architectures는 Qwen3_5ForConditionalGeneration입니다. 같은 방식으로 Qwen3.8-Flash-Next의 config.json도 열어봤는데, 오디오 키 0개는 동일했습니다.
GGUF 쪽도 사정은 같았습니다. ggml-org 공식 리포에 올라온 어댑터 파일은 mmproj-Qwen3.8-27B-BF16.gguf와 mmproj-Qwen3.8-27B-Q8_0.gguf 두 장뿐이었고,unsloth 미러도 BF16과 F16 두 장이었습니다. 모두 비전 전용이고, 오디오 어댑터 파일 자체는 존재하지 않았습니다. 홈시어터 리모컨을 샀는데 구성품에 영상 안테나만 있고 오디오 안테나 칸 자체가 비어 있는 셈입니다.
여기서 커뮤니티 표현에 한번 걸렸습니다. 모델 소개글에 도는 "audio-video 지원"이라는 말, 안을 열어보니 비디오(프레임)까지 영상 한 통으로 뭉갠 말투였습니다. 이 표현을 믿고 구현 일정을 잡았다면 일주일을 헛고생했을 겁니다.
혹시해서 허브를 뒤지니 누가 오디오 브릿지를 외부로 붙여둔 사제 개조 빌드(Omni-Audio-Bridge 같은 이름의 GGUF)가 실제로 발견되긴 했습니다. 다만 안전 정제를 지운 개조에 공식 검증도 없어서, 연구 랩 파이프라인에는 들여놓을 수가 없었습니다. 존재는 인정, 채택은 배제입니다.
통째로 갈아치우나, 귀만 달이나
이로써 상황이 정리됐습니다. 27B에 귀를 붙이는 길은 공식 웨이트에 없습니다. 실제 선택지는 두 개였습니다. 처음부터 듣고 말하는 Qwen3-Omni 계열의 올인원 S2S 모델로 통째로 갈아타는 것, 그리고 지금의 STT→LLM→TTS 캐스케이드를 유지하면서 '귀'인 프론트엔드만 채우는 것이었습니다.
앞쪽은 10월 마지막 주 새벽에 직접 체감해봤습니다. 올인원 계열은 활성 파라미터가 3B급으로 떨어지는데, 음성비서가 매일 돌리는 추론과 툴콜 단계에서는 로컬 27B 대비 확실히 밀렸습니다. 말은 잘하는데 정작 우리 제품 이야기는 잘 모르는 분에게 상담원을 맡기는 느낌이었습니다. 그래서 방향은 캐스케이드 유지, 프론트를 무엇으로 채울지가 남는 문제가 됐습니다.
Voxtral 3는 좋지만 우리 회의실로 못 옵니다
시장에는 이미 완성형이 있었습니다. Mistral이 10월 20일에 Public Preview로 낸 Voxtral 3인데, 구성이 5개입니다.
| 구성 | 특징 | 가격 |
|---|---|---|
| Mini Transcribe 3 | 4B, 배치 전사 | 분당 $0.0035 |
| Small Transcribe 3 | 구성 중 최고 정확도 | 분당 $0.0040 |
| Mini Transcribe Realtime 3 | 서브 500ms, 지연 예산을 세션별로 설정 | 분당 $0.008 |
| Mini TTS 3 | 35+ 언어·50+ 방언, 프리셋 18개 언어에 한국어 포함 | 1M 자당 $13 |
| Voice Agents SDK | LiveKit 기반 | 분당 $0.04~0.08 |
기능 면에서는 지금 나오는 음성 프론트엔드 중 가장 탐나는 조합입니다. 전사가 50개 이상 언어이고, 화자 분리(diarization)와 context biasing이 내장입니다. 후대는 파인튜닝 없이도 우리 프로젝트명이나 장비명 같은 용어 사전을 집어넣는 기능이라, 줄임말이 오가는 회의에서는 그 자체가 킬러입니다. 실시간판은 침묵 대신 어쿠스틱과 의미 두 축으로 화자 교대를 판단합니다. 공식 발표문은 Whisper, Scribe v2, Gemini 3.5 Transcribe를 앞선다고 주장하는데, WER 수치는 발표문 표로만 있어서 인용은 보류하겠습니다. SDK 구조는 "Each stage is a separate model, so you can change the LLM"이라는 공식 문구 그대로, 안의 언어 생성은 일반 텍스트 LLM이 담당하는 캐스케이드이지 올인원이 아닙니다.
그런데 이 서비스에는 우리랑 똑같은 지점에서 HN 불만도 제기되고 있습니다. 오픈웨이트가 아니라는 점입니다. 경로가 EU/US API나 자체 인프라 배포(비즈니스 계약)뿐이고, 무료 다운로드 웨이트는 아예 없습니다. 쓰려면 회의실 목소리와 학교 회의음이 해외 엔드포인트로 나가야 합니다. 이건 저희 회의실에서 제가 결정할 문제가 아니라서, 여기서 검토 종료였습니다.
귀를 달고 보니 NVIDIA 차고에서 0.6B와 100M이 나왔습니다
API를 배제하면 남는 건 오픈웨이트이고, 거기서 건진 게 NVIDIA의 두 웨이트였습니다.
하나는 Nemotron 3.5 ASR Streaming 0.6B입니다. 파라미터 6억 개에 Cache-Aware FastConformer-RNNT 구조(인코더 24 레이어 + RNNT 디코더 + language-ID 프롬프트)이고, 청크 크기를 80/160/320/560/1120ms 다섯 개 중 런타임에 고릅니다. 로케일 40개를 Transcription-ready 19개, Broad-coverage 13개, Adaptation-ready 8개 세 등급으로 나눠 놓았는데, 한국어 ko-KR이 1티어인 Transcription-ready 19개에 들어갑니다. 일본어나 중국어보다 상위 그룹이라는 점이 우리에게는 정확도 수치보다 반갑습니다.
공식 모델카드의 FLEURS ko-KR WER을 옮겨오면 이렇습니다. LangID 프롬프트 조건은 80ms에서 7.59, 1.12s에서 7.12이고, 자동 감지는 80ms에서 8.31, 1.12s에서 7.30입니다. 청크를 80ms에서 1.12s까지 늘려도 LangID 줄은 0.5%P도 안 떨어집니다(7.59 → 7.12). 인식 지연을 늘려봤자 정확도가 거의 그대로라는 뜻이라, 급하지 않은 배치 전사가 아니라 실시간 회의용으로 80ms를 자신 있게 고를 수 있습니다. 라이선스는 OpenMDW-1.1로 커머셜 무료입니다.
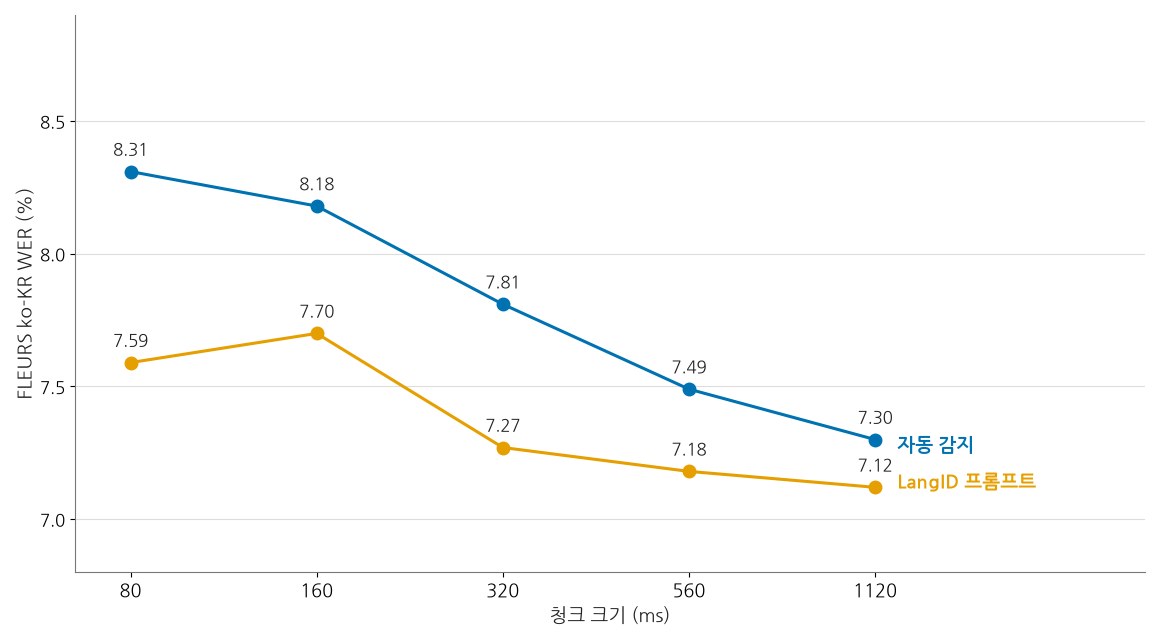
위 그림: 공식 모델카드의 FLEURS ko-KR WER를 청크 크기별로 그렸습니다. 주황이 LangID 프롬프트 조건, 파랑이 자동 감지입니다.
다른 하나는 Nemotron 3 Diarization 100M으로, 9월 23일에 공개됐습니다. 오픈웨이트에 파라미터 1억 개, 최대 8화자, 스트리밍과 오프라인을 겸용합니다. 단일 체크포인트로 80ms부터 30.4s 버퍼까지 다루고(권장 최소는 0.32s), chunked inference 덕에 회의 길이 제한도 없습니다. 구조가 제일 흥미로운데, 세그멘테이션→임베딩→클러스터링으로 이어지던 기존 방식(베이스라인은 diar_streaming_sortformer_4spk-v2.1)을 엔드투엔드 단일 모델로 접어 넣었습니다.
DIHARD III 전체 평가 DER을 비교하면 이렇습니다.
| 버퍼 | 기존 베이스라인 | Nemotron 3 Diarization |
|---|---|---|
| 30.4s | 19.09 | 12.73 |
| 1.04s | 19.60 | 13.18 |
| 0.32s | 19.85 | 13.55 |
버퍼를 0.32s로 확 줄여도 13%대를 유지합니다. 8개 평가 조건 평균 상대 개선 41%는 공식 블로그 수치이고, VoiceArena Diarization-Bench에서는 12개 시스템 중 1위 DER 14.72%(2위 19.3%)입니다. 처리량은 RTX PRO 5000에서 BF16 compile, batch 32 기준 RTFx 15,113배로 공식 표기되어 있습니다(베이스라인 2,619배). 이건 단일 스트림 지연이 아니라 배치 처리량 수치라는 단서를 공식 문서도 달아놓고 있습니다. 라이선스 역시 OpenMDW v1.1로 commercial이든 non-commercial이든 허용됩니다.
이 둘이 우리 회의실에 들어오면 의미하는 바가 구체적입니다. 지금 회의록 파이프라인은 전사와 화자 분리를 2단(whisper 계열 + pyannote 스타일)으로 배치 구동 중인데, 이 웨이트 두 장이면 그 2단을 통째로 교체하는 시도이기 때문입니다.
아직 모르는 것과 다음 순서
솔직히 안 한 일은 안 했다고 적어둡니다. 우리 한국어 회의 녹음으로는 아직 A/B를 돌리지 않았습니다. FLEURS나 DIHARD III 같은 공식 벤치와, 영어가 뒤섞인 발표와 프로젝트 용어가 난리부르스인 우리 도메인 사이에는 당연히 간극이 있을 겁니다. 특히 Voxtral의 킬러였던 context biasing, 그러니까 파인튜닝 없이 용어를 주입하는 기능은 이쪽에 대응이 없어서, 파인튜닝 로드나 사전 주입 경로를 따로 생각해야 합니다.
순서는 정해뒀습니다. 쌓아둔 회의록 파일 전사부터 오프라인 프로필로 A/B를 돌리고, 거기서 나온 숫자로 스트리밍 청크 크기를 결정한 뒤, 회의실 한구석 구형 게이밍 PC에서 도는 기존 라인의 교체를 시도하는 식입니다. LLM 홉 쪽에는 preserve_thinking이라는 또 다른 함정이 하나 더 남아있는데, 이건 한 편을 따로 낼 가치가 있어서 다음으로 아껴두겠습니다. A/B 숫자가 나오면 다시 들고 오겠습니다.
'공부 > 인공지능' 카테고리의 다른 글
| 프린터도 에이전트가 돌린다 — Kiln이라는 MCP 서버를 우리 프린터 앞에서 재봤습니다 (0) | 2026.10.27 |
|---|---|
| 에이전트를 웹앱 런타임으로 쓰려다 접었습니다 — 개발 인부로 쓰니 괜찮았습니다 (0) | 2026.10.26 |
| 29개 서비스를 대시보드 한 장에 모았더니, 외면하던 503의 정체가 보였다 (0) | 2026.10.25 |
| 파일 크기 21GB, 필요 VRAM 31.8GB — 오픈웨이트의 함정 두 개를 한 번에 배웠습니다 (0) | 2026.10.24 |
| Zotero를 헤르메스에 붙였다 — 심사 초대 논문 36권이 자동으로 서재에 들어온다 (0) | 2026.10.24 |