논문 투고를 하다 보니 그림 작업이 따로 노동이었습니다. 본문은 다 써놓고도 라벨이 어디서 겹치나 며칠이고 씨름하게 되거든요. 그래서 헤르메스 안에 그림만 그리는 전용 에이전트를 만들어보기로 했습니다. 막상 쪼개보니 이야기는 두 갈래로 갈렸습니다. 손에 있는 숫자로 matplotlib 그림을 그리는 데이터 피규어 쪽 하나, 배경 그림이나 이미지 편집 같은 생성형 쪽 하나였습니다. 데이터 피규어는 기존 논문 작성 에이전트에 스킬로 흡수해서 순조롭게 자리 잡았어요. 골칫덩이는 생성형 쪽이었습니다. 오픈웨이트 모델을 로컬에 올려보려다 기술 벽과 법적 벽에 연속으로 막혔습니다.
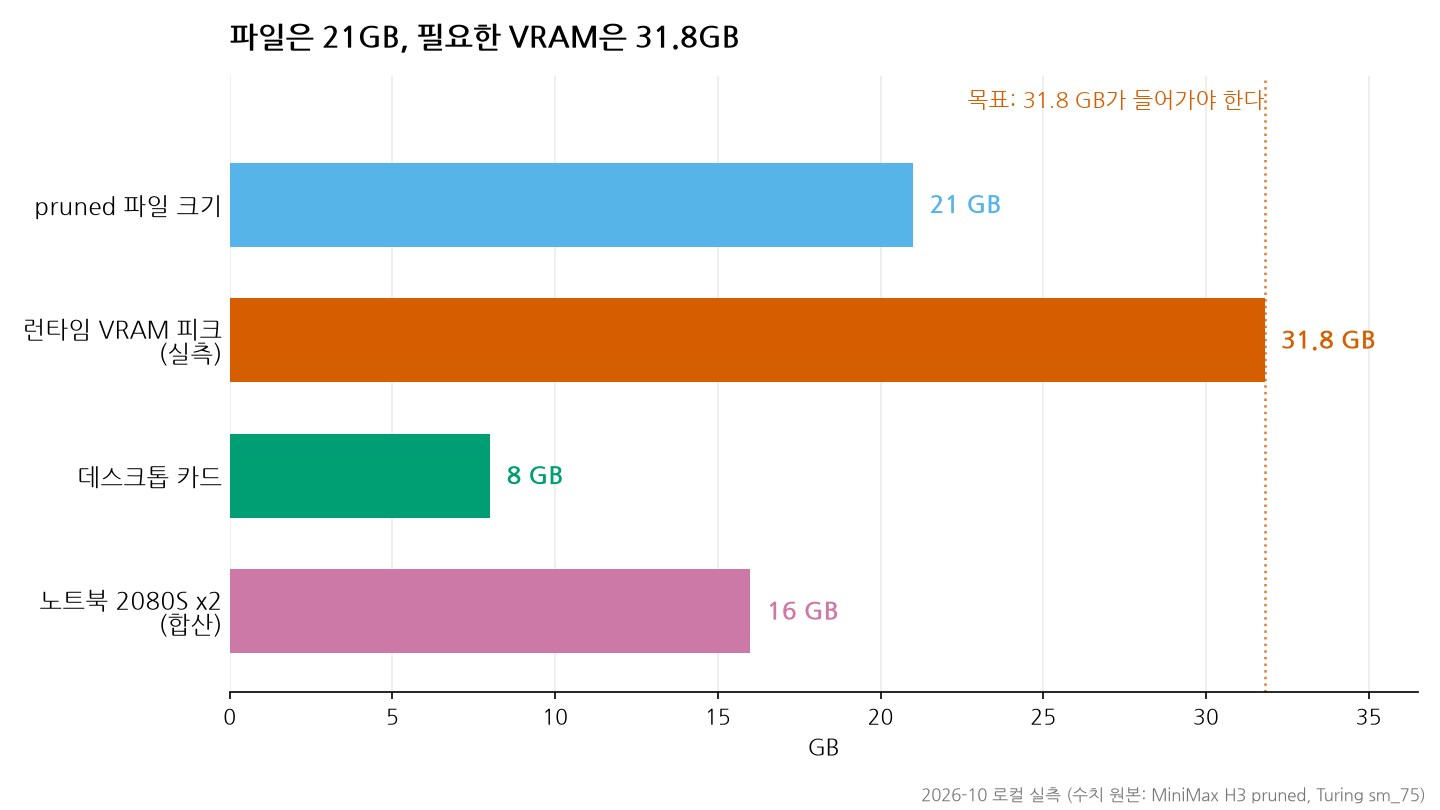
그림 요정을 따로 앉혔습니다
프로파일을 분리한 이유는 지극히 실무적이었습니다. 컨텍스트 오염이에요. 이미지 생성 작업은 대용량 출력(Blob)을 달고 다니는데, 이걸 텍스트 중심의 논문 작성 에이전트 컨텍스트에 섞어 놓으면 성능이 떨어지고 혼란이 생깁니다. 그래서 데이터 피규어는 논문 에이전트 안의 스킬로 넣고, 생성형과 이미지 편집은 별도 프로파일로 분리했습니다.
첫 열매가 paper-figure 스킬이었습니다. Nature나 IEEE 스타일 템플릿에, 색맹 배려 팔레트(Okabe-Ito)를 얹었고, 렌더링이 끝나면 비전 모델이 라벨 겹침과 깨짐을 검수하는 단계까지 붙였습니다. 모델이 그린 그림을 모델에게 다시 검수하게 하는 편이 낫거든요.
그리고 이 새 프로파일을 굴리려면 생성형 모델이 진짜로 필요했습니다. 여기서부터 이야기가 다른 길로 들어섭니다.
파일은 21GB, 실측 피크는 31.8GB
후보로 찍은 건 MiniMax H3라는 영상 생성 오픈웨이트 모델이었습니다. 던져 넣을 수 있는 기계는 두 대였어요. 데스크톱은 8GB 카드 하나를 달고 있었고, 노트북에는 2080 Super가 두 장 꽂혀 있었습니다. pruned 가중치 파일은 21GB. 합치면 16GB니까 안 되면 더 끼우면 되겠지, 하는 산수였습니다. 그런데 실제로 올려보니 런타임 VRAM 피크는 31.8GB였습니다. 파일 크기와 런타임 피크 메모리는 별개의 숫자였어요. 파일 크기가 작다고 낮은 VRAM 카드로 굴러간다고 단정하면 안 된다는 것, 이걸 몸으로 배웠습니다. 단체 손님 일행을 방 두 개에 재우려는 셈이었는데, 부지런히 챙겨 넣는 걸로는 안 되는 문제였습니다.
결정타는 그 뒤에 있었습니다. H3가 요구하는 최신 커널 스펙을 Turing 세대(sm_75)가 만족하지 못했어요. VRAM 용량의 문제가 아니라 아키텍처 자체가 아웃이었습니다. 결국 두 대 모두에서 한 인스턴스도 못 돌려봤습니다.
라이선스에는 "한국 제외"라는 글자가
솔직히 말씀드리면, VRAM을 계산하기 전에 먼저 열어봤어야 할 게 라이선스였습니다. HuggingFace의 MiniMax H3 COMMUNITY LICENSE 전문에 이런 조항이 들어 있었어요.
"Applicable Territory" means worldwide, excluding the Excluded Territories. "Excluded Territories" means the European Union, the United Kingdom, the Republic of Korea and the United States of America.
즉 가중치는 누구나 내려받을 수 있는데, EU와 영국, 한국, 미국 네 지역에서는 그 가중치를 실행하거나 복제하고 수정하고 배포할 라이선스가 없습니다. 제 노트북에서 돌리는 로컬 실행은 불법이 되는 구조였어요. 제외 지역에 살다가 쓰고 싶어지면 api@minimax.io로 별도 라이선스를 신청하라는 안내가 있고, API(Hosted Services) 서비스 자체는 이 지역에서도 이용 가능합니다.
공식 Q&A 문서도 열어봤습니다. EU AI Act처럼 규제가 진행 중인 지역이라 일단 공개하되 범위를 투명하게 제한해둔 거라는 설명이었어요. 표현대로라면 "not ever"가 아니라 "not yet"이었습니다. 언젠가는 문이 열릴 수 있다는 뜻이라 더 허무하네요. 재밌는 디테일도 하나 있었습니다. H3의 인코더 자체는 Qwen3-VL-32B 계열이라 그 부분만 보면 열려 있어요. Apache 2.0 계열이라 그런데, 통째로 된 라이선스가 지역을 싹둑 깎아둔 구조였습니다.
이번 시도에서 진짜 결정타는 31.8GB가 아니라 라이선스였습니다. 오픈소스 모델이라도 지역별 사용 제한이 있을 수 있어요. 로컬에 배포하기 전에 공식 LICENSE 문서부터 열어보시는 편이 좋습니다. 파일 크기만 보고 카드를 고르는 분은 저 말고도 많을 것 같은데, 정작 더 무서운 조항은 사양표가 아니라 지역 조항 쪽에 숨어 있었거든요.
작은 테스트에도 넘어졌습니다
이 시스템을 만들면서 겸손해지는 법 두 가지를 배웠습니다.
하나는 27b 비전 오해였습니다. 제 메모리에는 Qwen3.8-27b는 비전 불가라고 적혀 있었는데, 그걸 팩트처럼 믿고 있었어요. 실측해 보니 비전이 지원됐습니다. 잘못된 사실을 지우고 "지원함, 테스트는 224 이상 필수"로 교체했습니다. 에이전트 메모리 속의 단정은 주기적으로 실측과 대조하지 않으면 그 자리에서 상해요.
다른 하나는 해상도 함정이었습니다. 새 프로파일이 제대로 도는지 가볍게 확인하려고 10x10짜리 초소형 테스트 이미지를 넣었더니, 프로세서가 HTTP 400으로 거부하더라고요. 224x224 이상으로 올려야 정상적인 테스트가 됩니다. 비전 모델 쪽에는 "작은 이미지로 대충 확인"이 통하지 않는 영역이 있었어요.
그래서 어디에 돌리나
생성형 경로는 이미 갖고 있던 ComfyUI 서버 한 대에게로 회귀했습니다. SDXL과 Flux 워크플로우에 인페인트와 업스케일까지 다 갖춰져 있어서, 벽과 싸우는 것보다 여기로 붙이는 게 이롭더라고요. H3는 로컬을 포기하고 API나 향후 라이선스 확대를 관망하는 쪽으로 놓았습니다.
자원을 정리하면서 트래픽 분포도 눈에 들어왔습니다. 전체의 77.4%가 워크스테이션급 GPU 한 대에 몰려 있었어요. 나머지는 13.6%와 7.5%로 갈라졌는데, 리모트 서버 쪽 단일 모델 배포가 7.5% 수준이었습니다. 46GB급 리모트 카드는 지금 43.3GB가 쓰이고 있지만, 그 비중이 낮은 단일 배포를 옮겨 재배치하면 41GB를 확보할 수 있다는 계산이 나왔어요. 그러면 Apache 계열 그림 모델들을 태워볼 수 있습니다.
정직하게 한계를 적어둡니다. 재배치 안은 아직 실행하지 않았어요. 실제 생성형 수요를 관찰하는 단계이고, 실행은 그 뒤에 결정합니다. 이번 시도에서 확실히 확인된 건 두 가지뿐이었습니다. 8GB 카드 두 장짜리 기계로는 최신 생성형 모델이 원리적으로 불가능하다는 것, 그리고 H3는 이번 생성에서는 로컬이 끝이라는 것쯤이죠. 그림 요정 에이전트는 데이터 피규어 쪽으로 자리를 잡았으니 이번 주 논문 그림은 아무튼 잘 돌아가고 있습니다. 한국에서도 쓸 수 있게 됐다는 공지가 뜨는 날이 오면, H3는 그때 다시 찾아가 볼게요.
'공부 > 인공지능' 카테고리의 다른 글
| Zotero를 헤르메스에 붙였다 — 심사 초대 논문 36권이 자동으로 서재에 들어온다 (0) | 2026.10.24 |
|---|---|
| 메모리 슬롯은 하나뿐 — 세컨드브레인 52.5만 벡터를 헤르메스 안에 감쌌다 (0) | 2026.10.21 |
| DeepSeek 1017을 2대의 GB10에 돌리다 — TensorFold와 1M 컨텍스트의 실체 (0) | 2026.10.20 |
| API server down 경보를 받고 서버를 의심했습니다 — 로그가 거짓말한 겁니다 (0) | 2026.10.18 |
| 음성 비서가 느린 진짜 병목은 LLM 첫 토큰이었습니다 — 헤르메스 데스크톱에 로컬 음성 스택 붙이기 (0) | 2026.10.17 |