10월 26일 새벽, 음성 봇이 "28배" 빨라졌다고 보고했습니다. 첫음성이 3.75초 걸리던 것이 0.13초가 됐다는 겁니다. 저는 그 보고를 믿고 front 모델 교체까지 밀었습니다. 음성으로 답하는 모델 전체를 갈아끼우는 결정이었지요. 그런데 같은 날 낮에, 그 봇은 오히려 3배 느려졌다며 원복했습니다. 0.13초는 거짓이었고, 원인은 모델 서버를 방금 다시 켠 직후에 잰 것이었습니다.
범인은 모델이 아니라 배선이었습니다
문제 자체는 실물이었습니다. 음성 어시스턴트가 답을 꺼내기까지 첫음성만 3.75초, 한 문장 전체로 4.7초가 걸렸습니다. 무거운 모델을 얹어놔서 느린 줄 알았지요. 27B는 이름 그대로 270억 파라미터가 전부 계산에 참여하는 Dense 모델이었으니까요. 그런데 헬스체크 응답을 열어보니 front 모델은 flash-next에 thinking 모드가 켜진 채였습니다. 전날 서버 교체 결정을 음성 라인과만 이어붙이지 못한 배선 공백이었고, thinking 프리앰블이 첫음성을 통째로 늦추고 있었습니다.
그러면 뭐가 빠른지 재보자해서 후보를 세로로 나열했습니다. 35B-A3B는 활성 파라미터가 3B뿐인 MoE 모델입니다. 직원은 35명인데 실제 계산대에 서는 사람은 3명인 구조라, 몸집 큰 이름값과 달리 작은 기계에서도 돌아갑니다. 새벽 2시 30분에, 스트리밍으로 첫음성까지를 재면 이런 표가 나왔습니다.
| front 후보 (10/26 02:30 실측) | 첫음성 | 전체 응답 |
|---|---|---|
| 35B-A3B (thinking off) | 0.13s | 1.07s |
| flash-next (thinking off) | 0.21s | 1.49s |
| 27B (게이트웨이 경유) | 0.45s | 4.29s |
| flash-next (thinking on, 설치돼 있던 것) | 3.75s | 4.73s |
표의 1행이 승자였습니다. 설치돼 있던 3.75초의 28배라 보고하고, thinking을 끄고 35B-A3B로 front를 넘겼습니다. 실수는 여기서부터입니다. 지금 다시 봐도 아이러니한 게, 같은 표의 2행이 thinking만 끈 flash-next로 0.21초였습니다. 프리앰블을 끄고 배선을 꽂으면 끝날 일이었는데, 저는 그 행을 건너뛰고 모델 통째 교체라는 먼 길을 돌았습니다.
갈아탄 직후, 실전 바디로 재달았습니다
교체를 마친 직후에 음성 단말이 실제로 올리는 요청 바디를 그대로 가져와 재측정시켰습니다. 시스템 프롬프트와 도구 목록이 붙은 전문이고, 사용자 메시지는 "고마워" 한 줄입니다. 새벽 표가 첫음성만 자른 게 걸렸으니, 이번에는 답이 전부 나오는 시간(e2e)을 같은 기준으로 달았습니다. 27B와 A3B에 같은 바디를 3번씩 던졌습니다.
27B는 0.43초, 0.73초, 0.85초였습니다. A3B는 2.0초, 2.3초, 4.1초. 중앙값으로 0.73초 대 2.27초, 3.1배입니다. 생성 속도도 같이 무너져서 A3B의 디코딩은 3.6~8 tok/s를 넘지 못했습니다. 답 모양까지 느슨했습니다. "고마워"에 27B는 "천만에요! 더 필요하면 말씀해 주세요."로 답했는데, A3B는 그 한 줄을 4초에 걸쳐 뽑아냈습니다.
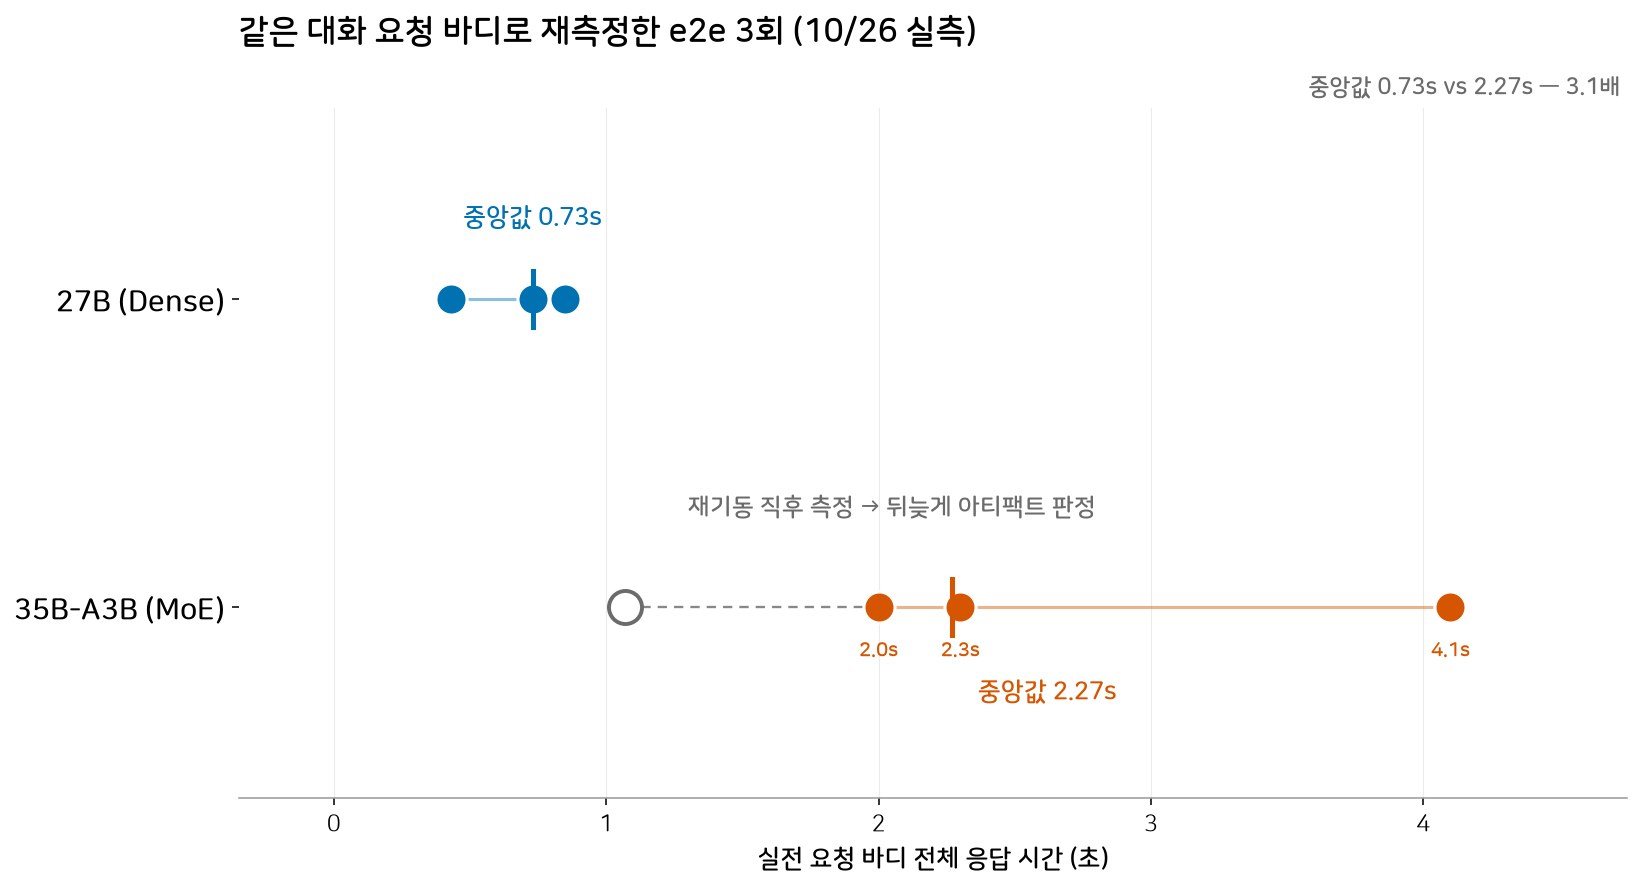
새벽에 28배 빨라진 모델이 낮에 3배 느려질 수는 없습니다. 측정 조건을 뒤졌습니다.
130ms가 믿을 만했던 세 가지 이유
첫째는 켠 직후에 잰 것입니다. llama.cpp는 GPU 연산을 재현하는 CUDA 그래프라는 기법을 씁니다. 모델을 방금 올린 직후의 몇 번은 이 그래프가 가장 좋은 조건에서 재생되기 때문에 유난히 빠르게 나옵니다. 새 차를 타고 도로가 텅 빈 심야에 한 번 달아놓고 출근길도 그 속도라고 주장한 셈입니다. 새벽 벤치는 A3B 서버를 재기동한 직후에 돌았고, 낮의 재측정은 서버가 안정에 들어간 뒤 한참 지난 상태였습니다.
둘째는 자른 자리가 달랐습니다. 0.13초는 첫 글자가 나올 때까지의 시간이고, 음성에서 체감하는 건 문장이 끝날 때까지입니다. 새벽 표에서도 이 기준을 섞었습니다. 전체 응답은 1.07초였고, 같은 e2e를 실전 바디로 재니 중앙값 2.27초가 나왔습니다. 조건 차이로만 두 배 넘게 벌어진 셈입니다.
셋째는 스킬에 박힌 옛 숫자였습니다. 9월의 스킬 문서에는 이 머신의 디코딩이 28 tok/s라고 적혀 있었습니다. llama-bench로 직접 깎아보니 tg32에서 11.9±7.2 tok/s가 한계였습니다. 28은 상태가 다른 시절의 숫자였고, 이 머신에 대한 제 상식은 이미 낡아 있었습니다.
대역폭이라는 벽, 그리고 덤으로 잡힌 장애
활성 파라미터 3B뿐인데 왜 이렇게 느린지도 확인했습니다. A3B이 올라간 곳은 2080 슈퍼 두 장이 전부인 한때 게임기였던 머신입니다. 카드 한 장이 8GB라 22GB 모델이 VRAM에 들어갈 리 없고, 32GB RAM에 전문가 가중치를 CPU 쪽으로 오프로드해서 겨우 얹었습니다. 계산대에 서는 사람은 3명인데, 그 3명이 자료를 쓸 때마다 지하실 창고까지 계단을 오르내리는 격입니다. 연산이 아니라 RAM에서 끌어오는 대역폭이 벽으로 보였습니다. MoE의 "활성은 3B뿐"과 "그래서 빠르다"는 별개라는 걸, 28배와 28 tok/s라는 팩트 두 건을 제 손으로 정정하면서 배웠습니다.
측정 과정에선 딴 장애 하나도 잡혔습니다. 리모트 서버의 게이트웨이 주소가 다른 머신에 재할당돼 되돌아오는 응답이 전부 401이었고, 그 앞을 지나던 클라이언트들이 이미 죽어 있었습니다. 인프라 쪽에 인수를 넘기고, 죽은 주소를 가리키던 문서를 고쳤습니다. 범인을 쫓다가 공범을 발견한 격이었습니다.
조건을 적지 않은 숫자는 숫자가 아닙니다
음성 front는 27B 직결로 되돌렸습니다. 느림의 실체는 thinking 프리앰블과 배선 공백이었으니, 프리앰블을 끄고 배선을 꽂는 쪽으로 정리했습니다. "28배"와 "28 tok/s" 두 팩트 항목은 같은 날 정정했고, 웜그래프의 130ms는 이제 어떤 벤치로도 믿지 않습니다.
이번 재측정도, 솔직하게는 표본이 작습니다. 모델당 3번, 바디는 "고마워" 한 종류뿐이라 "적어도 3배는 뒤집히지 않는다" 정도로 읽어야 합니다. 첫 턴 프리필이 30~60초 걸리는 콜드 문제는 건드리지 못한 채 다음 과제로 미뤄뒀습니다.
바뀐 것은 세 가지입니다. 서버를 켜고 식을 때까지 기다려서 재고, 같은 실전 바디로 비교하고, 첫 글자와 문장 전체를 같은 표에 섞지 않습니다. 음성 지금은 27B가 0.7초대에 답합니다. 130ms의 달콤한 거짓말이 그리울 것 같지는 않습니다.
'공부 > 인공지능' 카테고리의 다른 글
| 5일 연속 크론 4개가 죽었는데 알림은 0건이었습니다 (0) | 2026.11.07 |
|---|---|
| 살아 있다고 말하는 것들 — active·exit 255·CPU 99.9%가 전부 거짓말이었습니다 (0) | 2026.11.06 |
| 87쪽 연구보고서를 기계에 검토시켰더니 27군데가 나왔습니다 (0) | 2026.11.05 |
| L40 3장이 워크스테이션 1장보다 느립니다 — CPU가 AVX2 없는 kvm64였습니다 (0) | 2026.11.04 |
| 잡으려고 켜둔 감시자가 서비스를 죽였다 — GB10 통합메모리에서 earlyoom이 vLLM을 킬한 하루 (0) | 2026.11.03 |