단일 디코드 27.2 tok/s. 리모트 서버를 같은 벤치 스크립트로 다시 돌려본 결과입니다. GPU 카드 한 장뿐인 워크스테이션에서 같은 조건으로 재보니 46.7이 나왔습니다.
리모트 서버는 L40 세 장이 올라간 기계이고, 워크스테이션은 PRO 6000 96GB 한 장입니다. 카드 수에서도, 총 VRAM(48GB×3, 합계 144GB)에서도 리모트가 이기는데 속도에서 졌습니다. 병목은 GPU가 아니었습니다.
같은 조건으로 재측정하니 차이가 드러났습니다
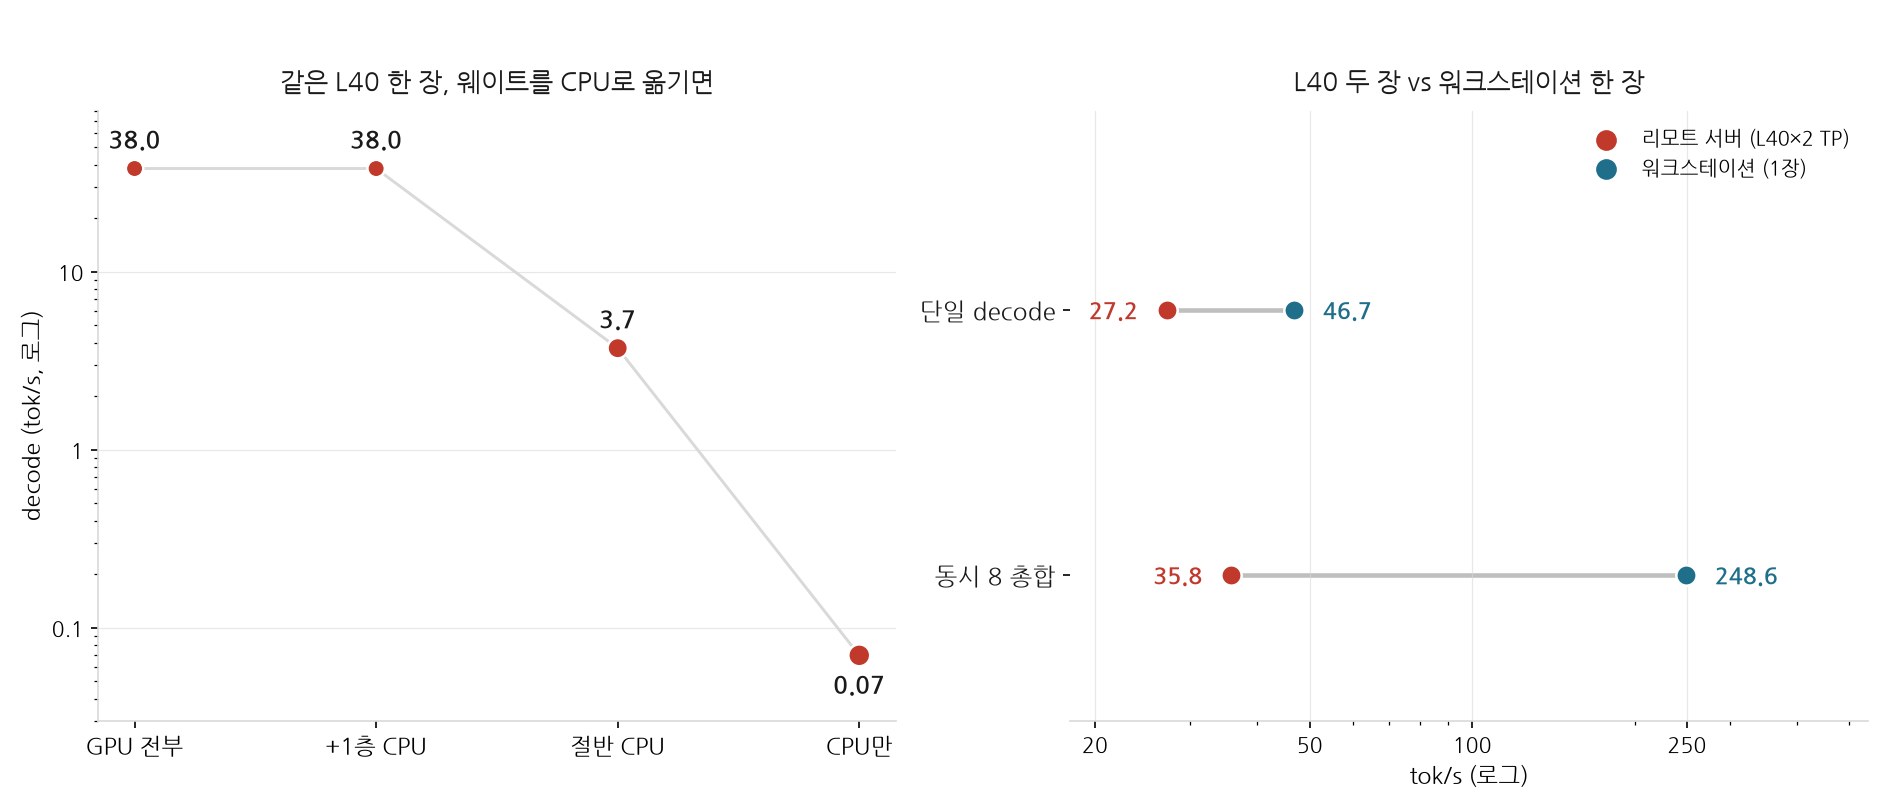
감으로 비교한 것이 아닙니다. 같은 27B 모델을 두 기계에 같은 스크립트로 돌리고 숫자를 나란히 세웠습니다. 왼쪽 열은 L40 두 장을 Tensor Parallel로 묶어 돌리는 현행 프로덕션이고, 오른쪽 열은 카드 한 장에 NVFP4 양자화와 DFLASH 추론 사양을 얹은 설정입니다.
| 지표 | 리모트 서버 (L40×2 TP, 현행 프로덕션) | 워크스테이션 (PRO 6000 1장, NVFP4+DFLASH, maxreq=8) | 배 |
|---|---|---|---|
| 단일 decode | 27.2 tok/s | 46.7 tok/s | 1.7배 |
| 동시 4 총합 | 23.3 tok/s | 155.6 tok/s | 6.7배 |
| 동시 8 총합 | 35.8 tok/s | 248.6 tok/s | 6.9배 |
| 8K 프롬프트 TTFT | 2,253 ms | 442 ms | 약 5배 |
TTFT는 첫 토큰이 나올 때까지 걸리는 시간입니다. 표를 보시며 미리 고백할 것이 있습니다. 리모트 서버 쪽 수치는 벤치 전용으로 구동해 쟀다가 아니라, 실제 트래픽을 받는 중인 서버를 그대로 재측한 값입니다. 동시 4 총합이 단일보다 오히려 낮은 것도, 같은 기계에서 실제 요청들과 경쟁한 채 쟀기 때문으로 보입니다(제 짐작입니다). 단일 디코드의 1.7배는 그래서 실제보다 더 어둡게 씌워진 숫자일 수 있습니다.
눈에 띄는 건 동시자로 갈수록 벌어지는 격차입니다. 단일에서는 1.7배인데 동시 8에서는 6.9배입니다. 동시에 몰릴 때 GPU가 아닌 무언가가 먼저 쥐어지고 있다는 징후로 읽었습니다.
범인은 CPU — AVX2를 통째로 잃어버린 kvm64였습니다
흔한 용의선부터 하나씩 확인했습니다. GPU 세 장은 모두 정상이고, PCIe는 Gen4 x16으로 세 장 다 잘 붙어 있습니다. RAM은 153GB 중 135GB가 쓰 가능합니다. GPU·버스·메모리의 '용량'은 전부 멀쩡했습니다. 빈 깡통이었던 쪽은 CPU였습니다.
이 가상머신의 CPU 타입은 kvm64였습니다. 하이퍼바이저가 기본값으로 자주 올려두는 가상 CPU 타입 이름인데, 물리 CPU의 명령어 세트 일부를 잘라낸 신세입니다. 요즘 CPU가 숫자더미를 한꺼번에 씹어먹는 데 쓰는 AVX2와 FMA 명령이 통째로 사라져 있었습니다. 다른 집은 전동 공구로 조립하는데 나는 손톱으로 나무를 깎는 격입니다.
vCPU는 8개에 불과했고, DRAM 읽기 대역폭은 8스레드 병렬 C 벤치로 실측 11.7 GB/s 나왔습니다. 단일 스레드는 7.4 GB/s였습니다. 용량은 채워져 있는데 길은 좁은 상태였습니다.
이렇게 길이 막혀 있으면 'VRAM이 모자라면 CPU로 내리면 되지'라는 상식 자체가 무너집니다. 웨이트나 KV 캐시를 CPU 쪽으로 내리고 필요할 때 빠르게 올리는 방식인데, 이 상식은 이 노드에서 전면 불가였습니다. 증거는 아래의 곡선입니다. L40 한 장에 llama-bench로 Q4_K_XL 양자화를 올려 재측정한 것이고, ngl은 GPU에 남기는 레이어 수입니다.
| 웨이트 적재 위치 | decode |
|---|---|
| GPU 전부 (ngl=99) | 38.0 tok/s (4k ctx 37.9) |
| 1층만 CPU (ngl=96) | 37.99 tok/s |
| 절반 CPU (ngl=50) | 3.72 tok/s |
| CPU만 (ngl=0) | 0.07 tok/s |
1층만 내려도 실질 변화가 없습니다. 절반을 내리면 3.72로 떨어지고, 전부 내리면 0.07입니다. 이유는 대역폭입니다. 웨이트는 16.3 GiB짜리고 매 토큰 이걸 다시 읽어야 하는데, 11.7 GB/s의 DRAM으로는 토큰당 약 1.4초라는 하한이 먼저 잡힙니다. KV 캐시 쪽도 262K 슬롯(4.1GB)을 읽는 데 토큰당 350밀리초, 약 2.9 tok/s가 한계였습니다. L40의 GPU 메모리 대역폭은 864 GB/s입니다. 약 70배 차이입니다. CPU로 내리면 조금 느려지는 게 아니라 취미가 달라집니다.
1층은 괜찮고 절반은 치명인 구간이 곡선으로 그어져 보이는 게 이 표의 핵심입니다. 웨이트를 GPU 밖으로 옮기는 오프로드 계열 전략 전체가, 이 가상머신에서는 애초에 선택지가 아님이 실측으로 확인됐습니다.
계층 캐시를 붙여봤지만, 열린 건 속도가 아니었습니다
다음으로 손댄 건 SGLang의 계층 캐시(hicache)였습니다. GPU에서 밀려난 세션의 KV 캐시를 host RAM으로 내려두었다가 돌아올 때 끌어올리는 구조입니다. 방은 그대로인데 프런트에 공동 옷장을 하나 더 들이는 셈이라, 짐작대로 디코드 속도 자체는 기대할 게 아니었습니다.
L40 노드에 실제로 기동해서 host pool을 붙이는 데 성공했습니다. 277,365 tokens(40.90 GB) 크기였습니다. 부착은 됐는데 decode tok/s는 그대로였습니다. 이 캐시가 올리는 건 세션 수용력과 재사용 속도였습니다. 8B 모델로 실증했는데, 추방(evict) 후 다시 불러온 세션의 첫 토큰까지 시간이 62ms였습니다. 약 20배 개선입니다. 쓸 수 있는 RAM이 135GB이니 host pool에 40GB를 주면 64K 길이 세션을 여럿 더 재울 자리가 생기고, 120GB를 주면 더 넓어집니다. 용량 레버로는 유효했습니다.
다 끝내지 못한 건 27B 하이브리드 모델과 hicache의 조합입니다. 요청당 147MB씩 mamba state까지 자리를 잡아달라고 하는데, GPU 빈 자리가 약 2GB 모자라 기동조차 못 했습니다. hicache의 잘못이 아니라 자리 문제였고, 이건 지금도 미결로 남아 있습니다.
반전 — 같은 카드, 새 빌드에서 70.9
CPU가 바닥임을 확인한 바로 그 주에, 예상 밖으로 GPU 쪽 숫자가 움직였습니다. 신규 llama.cpp 빌드에 MTP라는 드래프트 헤드가 내장돼 있었습니다. 같은 L40 한 장으로 디코드를 돌려보니 70.9 tok/s였습니다. 현행 프로덕션으로 돌던 구 빌드의 27.2 대비 2.6배입니다. 같은 신규 빌드에서 MTP만 끄면 39.1이었습니다. 게인이 MTP 쪽에 선명하게 있습니다. 드래프트 수용률은 59~65%, 받아들여진 드래프트의 평균 길이는 2.75~2.93로 집계됐습니다.
MTP은 모델 스스로 다음 토큰 몇 개를 미리 드래프트 해두는 방식입니다. 친구가 내 할 말을 미리 예상해서 한 번에 맞춰보듯, 맞은 개수를 한꺼번에 확인하며 시간을 번 구조입니다. 우선순위로 잡아둔 1안은 이 MTP 서버를 상시 3번째 레인으로 승격시키는 것입니다. 70~75 tok/s 레인이 하나 추가되니 총량이 약 +30% 늘 것으로 계산해뒀고, 아직 적용 전입니다.
그래도 남는 건 가상머신 CPU의 벽입니다. 새 빌드는 GPU 쪽에서 당긴 레버이고, kvm64의 대역폭은 그대로입니다.
아직 남은 것들
해소책은 가상머신의 CPU 타입을 host로 바꿔 물리 CPU의 명령어를 그대로 빌려 쓰는 것입니다. 콜드 리부트가 필요한 작업이라 승인을 기다리고 있습니다. 27B와 hicache의 조합은 실증하지 못했고, 물리 호스트 기준의 오프로드 수치와도 아직 비교하지 못했습니다. 동시 4 수치는 위에서 고백한 대로 실트래픽이 섞인 측정이라 클린 재측이 필요합니다. 화려하지 않은 실무 문제도 하나 있습니다. 디스크가 94% 찼고 여유가 57GB뿐이라, 모델을 더 얹기 전에 이걸 먼저 비워야 합니다.
GPU를 사는 것과 GPU를 쓰는 것은 다른 일이었습니다. 가상머신 위에서는 카드 수가 아니라 CPU의 명령어 세트와 메모리 대역폭이 조용히 하한선을 정하고 있었습니다. 앞으로는 하이퍼바이저의 기본값을 먼저 의심하게 될 것 같습니다. 승인이 나면 교체 후의 숫자로 또 돌아오겠습니다.
'공부 > 인공지능' 카테고리의 다른 글
| 잡으려고 켜둔 감시자가 서비스를 죽였다 — GB10 통합메모리에서 earlyoom이 vLLM을 킬한 하루 (0) | 2026.11.03 |
|---|---|
| 라벨 560mAh 배터리를 테스터로 쟀더니 약 200mAh — 문패 배터리 오독 해부 (0) | 2026.11.02 |
| 3.19TB 이관 ETA가 76일이라고 나왔습니다 — 범인은 도쿄를 거치는 릴레이 경로 (0) | 2026.10.30 |
| 잭 도시의 그 음성 모델, 뉴스에선 오픈소스라던데 공식 페이지에 웨이트가 없었습니다 (0) | 2026.10.29 |
| 27B에 귀를 달아봤더니 웨이트에 귀가 없었다 — 오픈웨이트 0.6B에서 찾았습니다 (0) | 2026.10.28 |