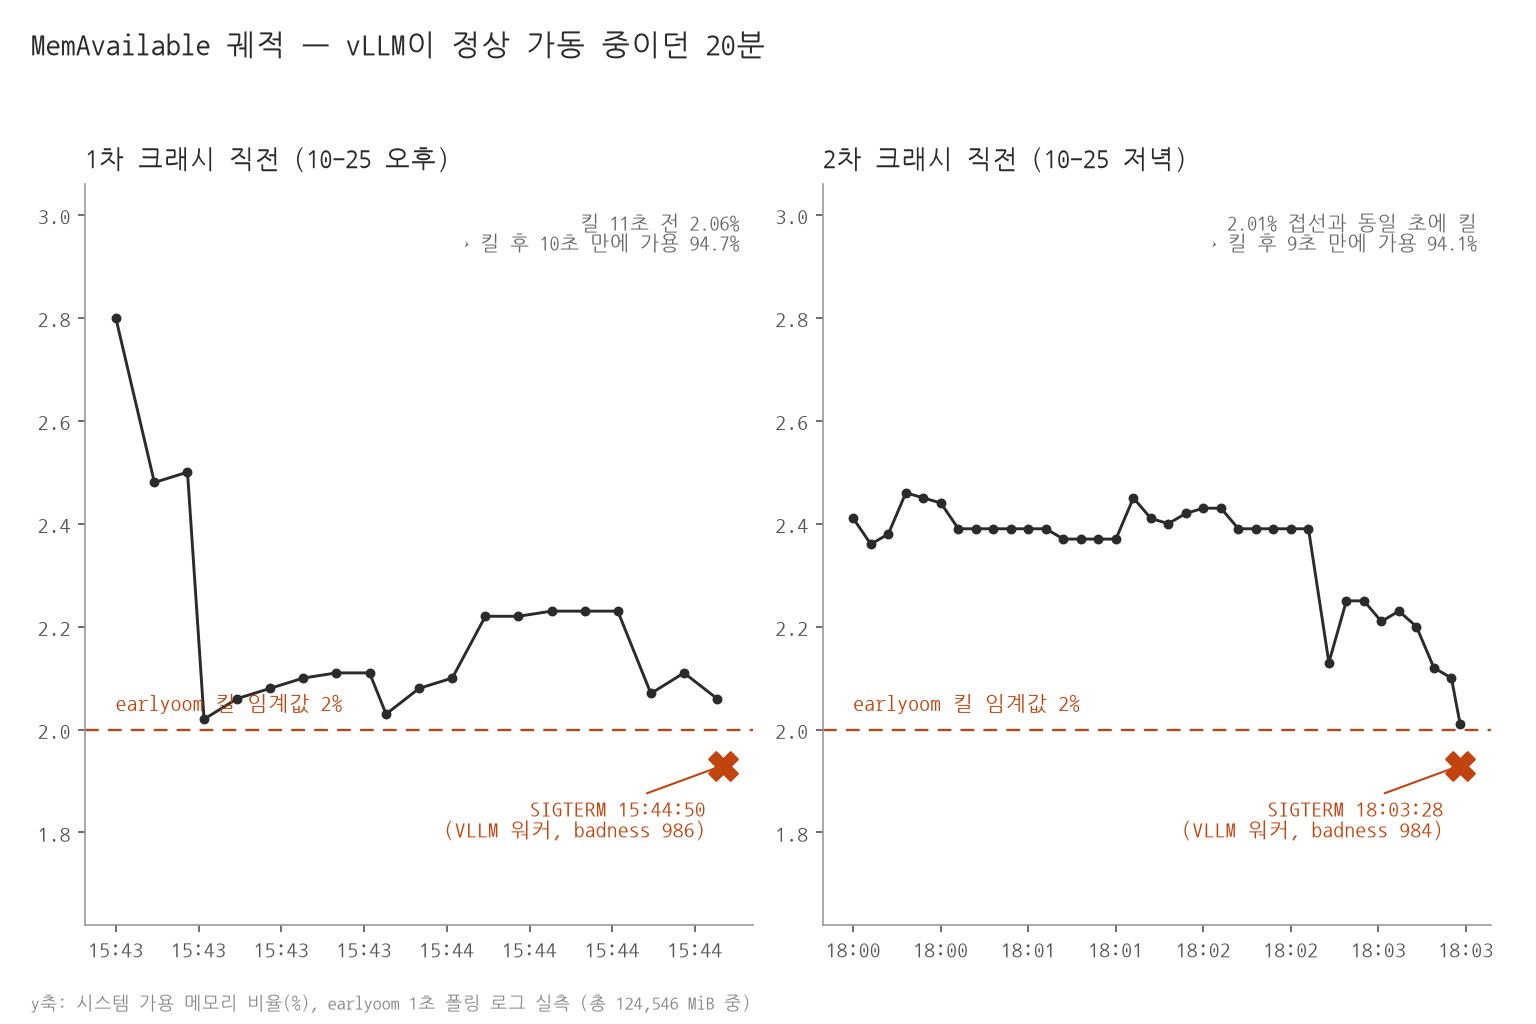
2026-10-25, GB10 듀얼(128GB 통합메모리를 나누는 두 노드에서 vLLM 1M 컨텍스트를 서빙 중)에서 서비스가 낮에 두 번, 저녁에 한 번 죽었습니다. 부팅 후 6일 넘게 아무 탈 없이 돌던 스택인데, 그날 코드도 모델도 설정도 한 줄 건드리지 않았습니다. GPU 연산 오류도 모델 오류도 흔적이 없었어요. 범인은 메모리를 지키려고 켜둔 감시 데몬 earlyoom이었습니다. NVIDIA 공식 셋업이 기본으로 넣어준 녀석이에요.
earlyoom의 일은 단순합니다. 가용 메모리가 2% 아래로 떨어지면 "나쁜 점수(badness)"가 가장 높은 프로세스를 먼저 끝내는 것. 메모리를 지키는 파수꾼이고, 보통 기계에서는 아주 합리적인 선입니다. 그런데 통합메모리 머신에서는 그 2%가 평상시 가동 영역이었습니다. 사건은 전부 이 하나에서 시작됐습니다.
킬 로그 타임스탬프, 크래시와 초 단위로 일치
처음은 아침에 왔습니다. VllmWorker-0 died unexpectedly 라는 로그만 남기고 워커가 조용히 사라졌어요. 오후 15:44에 한 번, 저녁 18:03에 또 한 번. 하루에 세 번입니다.
거슬러 올라가니 journalctl -u earlyoom 안에 프로세스를 끝냈다는 기록 두 건이 있었습니다.
| 킬 로그 | 시각 (KST) | badness | VmRSS |
|---|---|---|---|
| 1차 | 10-25 15:44:50 | 986 | 2639 MiB |
| 2차 | 10-25 18:03:28 | 984 | 2902 MiB |
둘 다 VLLM::Worker_TP이라는 이름의 프로세스에 SIGTERM을 보내겠다고 적혀 있었고, vLLM 엔진이 죽은 시각(UTC 06:44:57 / 09:03:34, KST 15:44 / 18:03)과 초 단위로 일치했습니다. 서비스를 죽인 게 감시자라는 사실이 여기서 확정됐어요.
earlyoom은 헤드 유닛에만 active했고 워커 유닛에는 없었습니다. 2026-08-26부터 NVIDIA 공식 셋업(sparkrun setup earlyoom)이 넣은 기본값 -m 2 -s 80 --prefer '(vllm|VLLM|...)' 그대로 돌고 있었어요. "vLLM은 먼저 끝내라"고 지목해둔 prefer 정규식 자체가 기본값에 이미 들어 있던 설정이었다는 점은 뒤에서 중요해집니다.
다만 아침 첫 크래시의 킬 로그 행은 journal에 남아 있지 않았습니다. 크래시 서명은 오후 두 건과 같은데 증거를 못 확보했으니, 이번에는 킬 로그로 직접 입증된 두 건만 확인된 사실로 취급합니다. 아침 건은 그 직후 재기동까지 실패한 다른 사고(백그라운드 로그 디렉터리 미존재)가 겹쳤을 가능성이 남아 있어요.
이 기계에서 2%가 평상시 체온인 이유
GB10은 GPU와 CPU가 메모리를 하나로 공유하는 설계입니다. 128GB짜리 하나를 둘이서 같이 쓰는 구조라, 실측 MemTotal은 124,546 MiB예요. 보통 PC처럼 CPU용 RAM과 GPU용 VRAM을 따로 세는 습관대로면 지갑이 두 개인 셈인데, 이 기계는 지갑 하나를 두고 둘이 번갈아 카드를 긁는 구조입니다. 그래서 1M 컨텍스트 모델이 올라가면 host의 MemAvailable 정상 대역이 2.4~3.7%까지 내려앉아요. 당일 실측도 06:59에 2.98%, 15:40에 2.95%, 18:00에 2.41%였습니다.
earlyoom의 기본 임계값 2%는 이 정상 대역과 겹칩니다. 요청을 처리하며 메모리 저점이 조금만 올라와도 감시자가 망치를 들어올렸어요. 킬 직전 궤적은 그 장면이 선명합니다.
1차는 15:43:16에 가용 메모리 2.02%(2,520 MiB)로 접선을 시작으로 2.0~2.1%를 오르내리다 15:44:50에 킬됐습니다. 2차는 더 정확해서, 18:03:28에 2.01%(2,499 MiB)에 접선한 바로 그 초에 킬됐어요.
그리고 킬 직후 샘플이 결정적입니다. 15:45:01에 가용 94.73%, 18:03:37에 가용 94.07%. 워커가 죽자 가용 메모리가 순식간에 94%로 튑니다. 냉동고에 2%만 남았다고 경비원이 안에서 재료 쓰던 요리사를 쫓아냈더니, 쫓아낸 순간 냉동고가 94%로 가득 찬 격이에요. earlyoom이 지키려던 "부족한 메모리"는 vLLM이 정상적으로 쓰고 있던 메모리였습니다.
earlyoom의 설계 철학 자체는 정당합니다. 커널 OOM 킬러가 시스템 전체를 쓸어가기 전에 하나만 먼저 정리한다는 구조니까요. 보통 기계에서는 훌륭한 파수꾼이고, 문제는 이 머신의 "정상"이 기본값의 "비정상"과 겹친 것을 아무도 조정하지 않았다는 데 있었습니다.
badness 공식을 두 번 틀리고, 세 번째 시정
범인을 잡았으면 감점 규칙을 고쳐야 합니다. 여기서 저는 두 번 연속 틀렸어요. 1차 판단은 23:05에 나왔습니다. badness를 oom_score 기반의 가중합 공식으로 계산해서, avoid에 -1000을 넣으면 vLLM을 실질적으로 킬 대상에서 제외할 수 있다고 결론냈지요. 틀렸습니다.
23:10에 man earlyoom을 펼쳤습니다. badness는 0~1000 스케일이고 prefer는 +300, avoid는 −300이더라고요. RSS가 점수의 밑값이라 vLLM 워커의 2.9GB를 RAM 대비로 환산하면 점수 23000 이상이 나오고, ±300은 1.3%에 불과합니다. 그래서 "avoid는 무력하고 진짜 레버는 -m 임계값뿐"이라는 꽤 자신만한 결론을 냈어요. 이것도 틀렸습니다. 문서까지 읽고 공식을 잘못 적용한 케이스였습니다.
23:18, 헤드 머신의 v1.7 man 실존 문구와 /proc 실측을 대조해서 세 번째로 뒤집었습니다. prefer는 oom_score에 +300, avoid는 −300을 더하는 0~1000 스케일이 맞는데, 이 머신(cgroup v2 회계)에서는 모든 프로세스의 oom_score가 RSS와 무관하게 ~660-680까지 부풀려져 있었어요.
| 프로세스 | RSS | oom_score | oom_score_adj |
|---|---|---|---|
| pipewire | 2.7 MB | 800 | 200 |
| systemd | 6 MB | 733 | 100 |
| vLLM | 1.1 GB | 682 | 0 |
2.7MB짜리 pipewire가 800점, 1.1GB짜리 vLLM이 682점입니다. 용량은 거의 반영이 안 돼요. 모든 프로세스의 밑점이 600~700대로 부풀려진 상태라 이 저역대에서 ±300은 약 45%를 움직이는 결정적 레버였습니다. badness는 경비원이 "누구를 먼저 내보낼까" 볼 때 쓰는 점수예요. prefer는 나쁜 점수 +300을 얹는 것이고 avoid는 관대한 점수 −300을 주는 것인데, 밑점이 23000 이상이면 ±300은 티도 안 나고 밑점이 680쯤이면 결과가 바뀝니다. 그날 저는 앞쪽 전제로 계산했는데 실제 기계는 뒷쪽이었습니다.
결정적인 확인은 그날 로그 숫자 재현이었습니다. 킬 로그의 badness 986 = 686 + 300으로 정확히 떨어졌어요. vLLM의 밑점 686에 prefer의 +300이 얹힌 값이었고, avoid는 무력한 게 아니라 유효했습니다.
함정은 하나 더 있었습니다. 기존 --prefer 정규식에 이미 vllm|VLLM|python3|python이 들어 있어서, prefer를 그대로 두고 avoid만 추가하면 같은 프로세스가 +300과 −300을 동시에 받아 서로 상쇄(986 그대로)됩니다. 여전히 1순위 희생양이에요. prefer 쪽에서 vllm 계열을 빼는 것이 선행 조건이었습니다.
고친 뒤의 실제 — 킬 0건, 8일째, 그리고 얇은 여유
이 머신에 적용된 설정(실측)은 이렇게 정리됐습니다.
-m 1 -s 80
--prefer '(sglang|llama-server|llama-cli|trtllm|tritonserver|ray)'
--avoid '(systemd|sshd|dockerd|containerd|dbus-daemon|NetworkManager|vllm|VLLM)'
prefer에서 vllm 계열을 빼고 avoid로 옮겨담고, 임계값도 -m 2에서 -m 1로 내렸습니다. 10-26 01:44에 새 설정으로 데몬을 재시작해서 배너 로그에 mem <= 1.00%가 찍힌 것을 확인했고, 이후 journal을 직접 카운트해 킬 이벤트는 0건입니다. 1M 서빙은 무사히 8일째 도는 중이고 11-03 현재 health check는 200을 돌려줍니다. 재시작 직후 관측된 MemAvailable 최저치는 약 6.3%(당일 새벽 기준)로 새 임계값 1%와는 여유가 크지만, 특정 시점 스냅샷이라 이대로 평생 6%대로 간다는 말은 아닙니다.
1%라는 값에도 경계는 남아 있어요. 킬 트리거가 된 저점이 2.0%였으니 1%는 "겹치지 않게 옮긴 최소 이동"이고 안전 여유는 얇습니다. 모델이나 KV 캐시 설정이 바뀌면 임계값을 다시 점검해야 하는 과제로 남겨뒀어요.
덤으로 배운 통합메모리 회계 함정 세 가지
earlyoom을 정리하고 보니 같은 뿌리, 통합메모리 회계의 함정이 더 있었습니다. 첫 번째는 고아 워커입니다. 헤드 유닛 엔진이 죽어도 워커 유닛의 컨테이너는 Up 상태로 남는데, 헤드만 단독 재기동하면 NCCL desync에 막혀요. 재기동 절차는 pair-restart 전용 스크립트로 정본화했습니다.
두 번째는 cudaMalloc이 cgroup에 안 걸리는 문제입니다. 10-28 GB10 커뮤니티 보고에 따르면 Docker의 --memory 캡이 통합메모리 프리즈를 막지 못했고, 그날의 프리즈 두 번 모두 파워사이클이 필요했어요. 세 번째는 SGLang 회계 누락으로, 커뮤니티 레포 문서에 따르면 통합메모리 풀 회계가 일시 할당 25~40GB를 놓치는 탓에 풀이 0이 되는 순간 기계가 얼어붙습니다. --gpu-memory-utilization 계열이 실질 가드이고, page cache를 주기적으로 비우는 cacheguard류 데몬도 대응으로 쓰이고 있어요. 세 가지에 공통된 교훈은 이겁니다. 통합메모리 머신에서는 프로세스 단위 메모리 회계를 신뢰할 수 없고, GPU 용량과 RAM 용량을 따로 재던 습관부터 버려야 해요.
그래서 이 사건에서 진짜로 남은 건 badness 공식을 두 번 틀린 그 부분입니다. 두 번째(23:10)는 man 페이지를 읽고도 공식을 잘못 적용해 "avoid는 무력하다"는 자신만한 결론을 냈고, 그것을 뒤집은 건 더 정밀한 계산이 아니라 그날 로그의 실측 숫자(986 = 686 + 300) 재현이었어요. 감시 시스템의 공식은 문서가 아무리 유력해도 로그 값으로 역산해서 맞는지 확인해야 합니다. 아침 첫 크래시의 킬 로그를 못 찾은 건 남는 미해결이고, earlyoom 킬 감지(journalctl -u earlyoom grep)는 일일 리포트 크론의 상시 항목으로 넣어뒀습니다. 관측은 호스트 감시자와 게이트웨이 폴링, LAN 독립 관측점 세 갈래로 재배치할 예정이고요. 감시자가 주인을 죽인 사건은, 숫자로 맞잡고 나서야 비로소 재밌어집니다.
'공부 > 인공지능' 카테고리의 다른 글
| 라벨 560mAh 배터리를 테스터로 쟀더니 약 200mAh — 문패 배터리 오독 해부 (0) | 2026.11.02 |
|---|---|
| 3.19TB 이관 ETA가 76일이라고 나왔습니다 — 범인은 도쿄를 거치는 릴레이 경로 (0) | 2026.10.30 |
| 잭 도시의 그 음성 모델, 뉴스에선 오픈소스라던데 공식 페이지에 웨이트가 없었습니다 (0) | 2026.10.29 |
| 27B에 귀를 달아봤더니 웨이트에 귀가 없었다 — 오픈웨이트 0.6B에서 찾았습니다 (0) | 2026.10.28 |
| 프린터도 에이전트가 돌린다 — Kiln이라는 MCP 서버를 우리 프린터 앞에서 재봤습니다 (0) | 2026.10.27 |