MOE 2

유휴 2080 두 장에 뭘 넣을까 — 64K로 줄이니 1.5배 빨라졌습니다

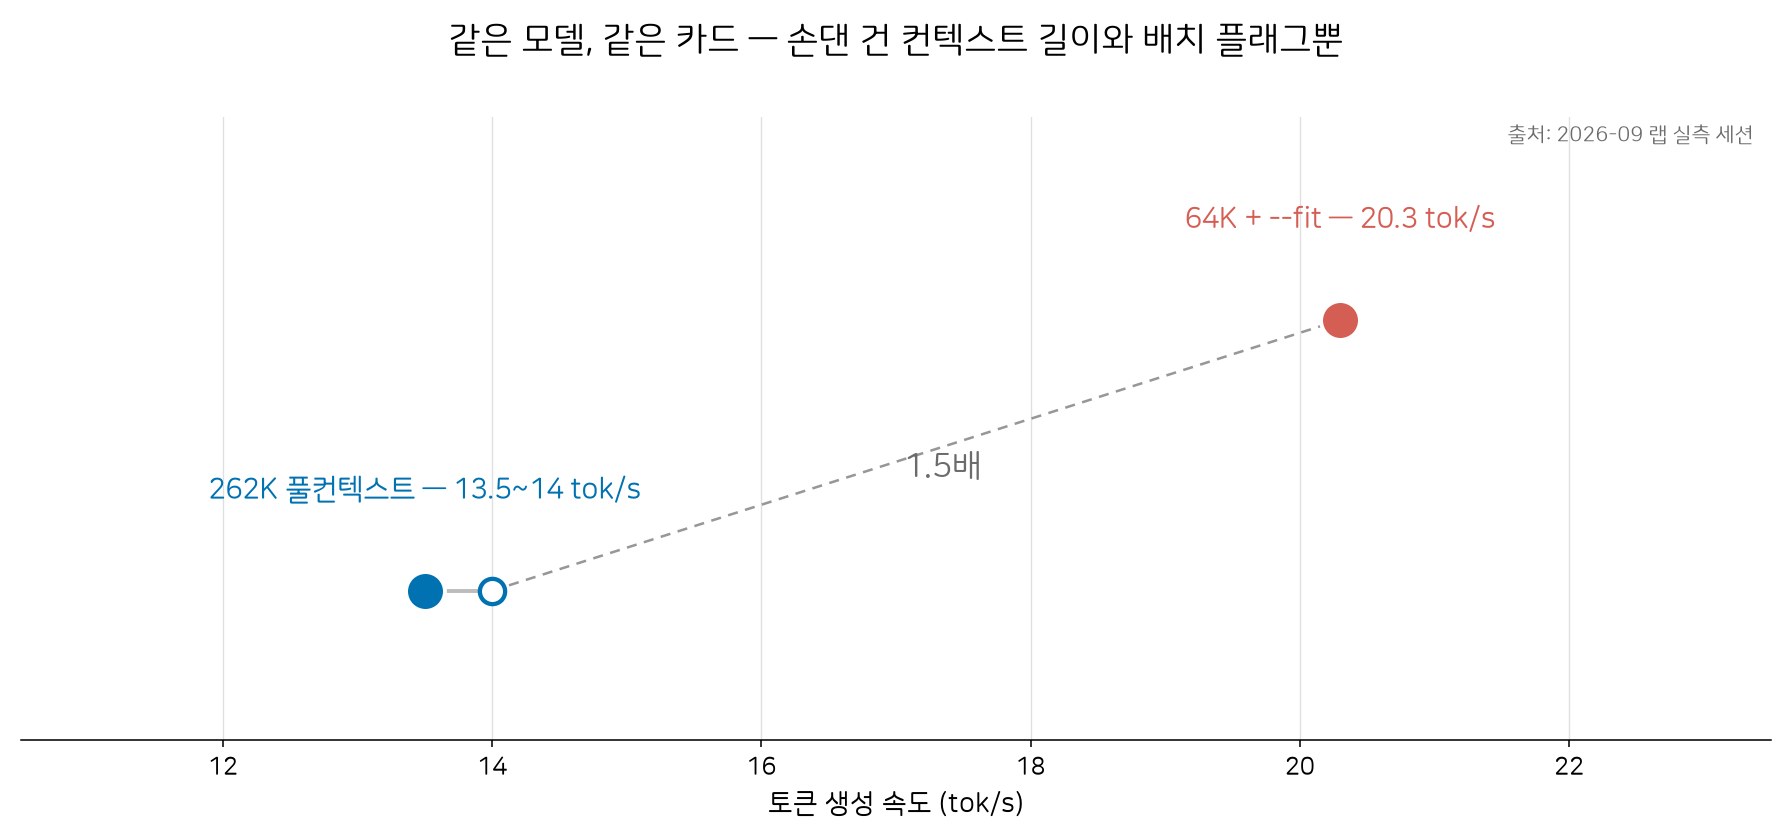
선풍기만 돌던 구형 데스크톱 하나를 가지고 있었는데, 그 안에 VRAM 8GB짜리 카드가 두 장 꽂혀 있었습니다. 하는 일 없이 놀고 있었으니 버리자니 아깝고 굴려보자니 걱정되는 상태였죠. 먼저 숫자부터 말씀드립니다. Qwen 35B-A3B를 262K 풀컨텍스트로 올려보니 생성 속도가 13.5~14 tok/s였습니다. 손댄 것은 컨텍스트를 64K로 줄이고 배치를 정하는 플래그 두 개뿐이었어요. 모델을 바꾼 적도, 하드웨어를 산 적도 없는데 속도는 1.5배가 났습니다.놀고 있던 카드 두 장대상 머신은 윈도우 워크스테이션 한 대입니다. 튜링(Turing) 세대의 RTX 2080 Super를 두 장 꽂아두고 RAM은 32GB인 기계로, 몇 년째 별다른 작업 없이 부팅만 되던 상태였어요. 계획은 이 두 장에 Q..
공부/인공지능 2026.11.14

백업 모델로 갈아탔더니 3배 느려졌습니다 — 웜그래프가 거짓말한 130ms

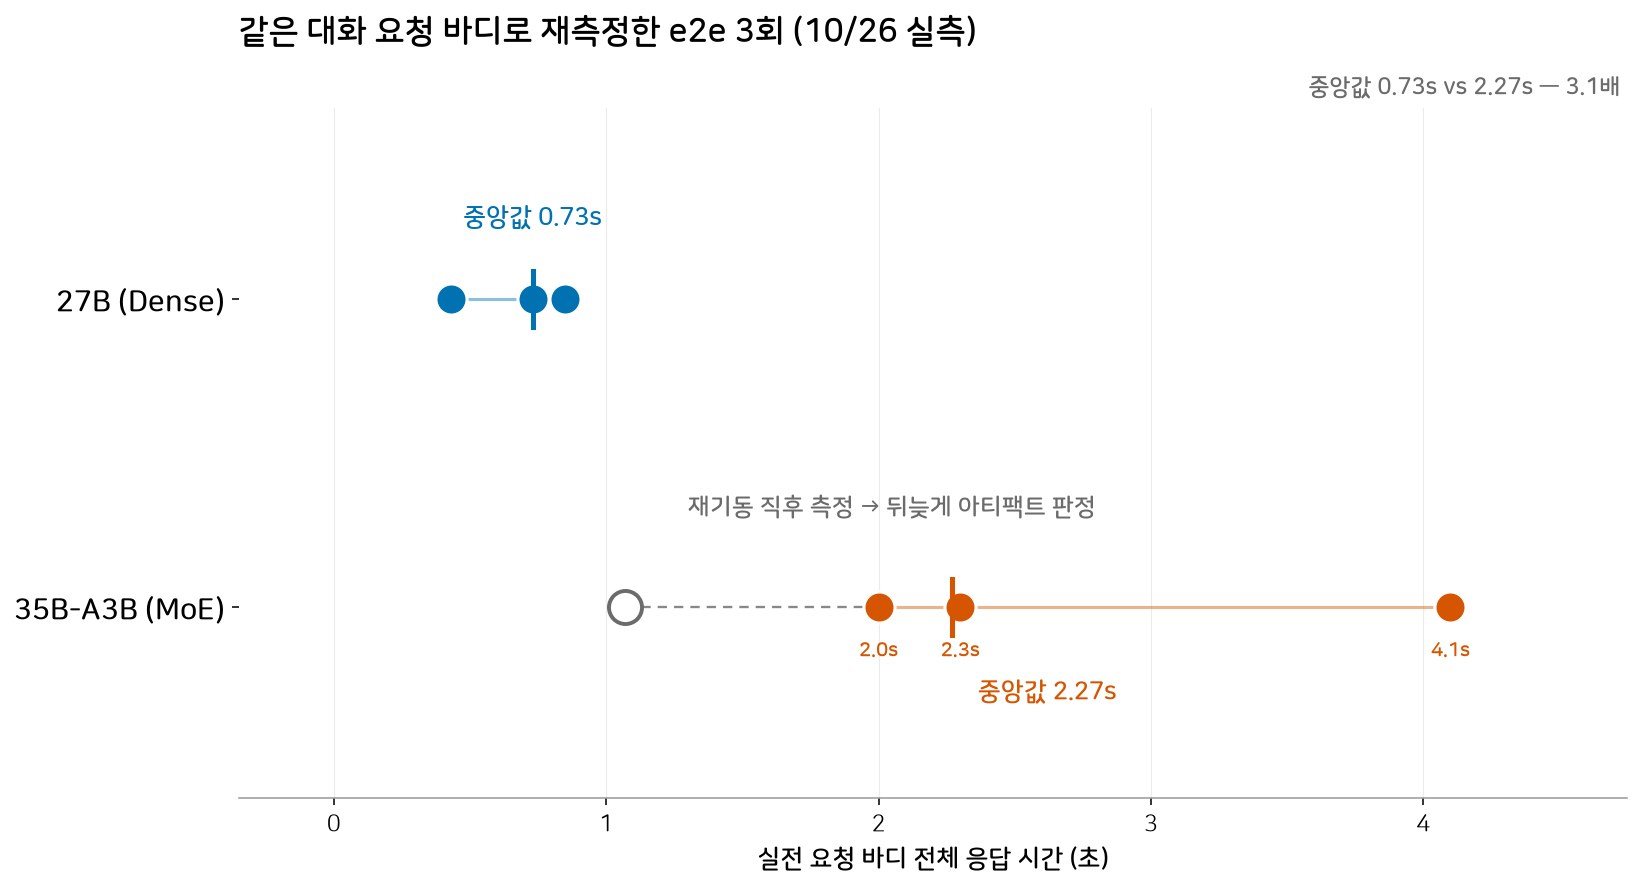
10월 26일 새벽, 음성 봇이 "28배" 빨라졌다고 보고했습니다. 첫음성이 3.75초 걸리던 것이 0.13초가 됐다는 겁니다. 저는 그 보고를 믿고 front 모델 교체까지 밀었습니다. 음성으로 답하는 모델 전체를 갈아끼우는 결정이었지요. 그런데 같은 날 낮에, 그 봇은 오히려 3배 느려졌다며 원복했습니다. 0.13초는 거짓이었고, 원인은 모델 서버를 방금 다시 켠 직후에 잰 것이었습니다.범인은 모델이 아니라 배선이었습니다문제 자체는 실물이었습니다. 음성 어시스턴트가 답을 꺼내기까지 첫음성만 3.75초, 한 문장 전체로 4.7초가 걸렸습니다. 무거운 모델을 얹어놔서 느린 줄 알았지요. 27B는 이름 그대로 270억 파라미터가 전부 계산에 참여하는 Dense 모델이었으니까요. 그런데 헬스체크 응답을 열어..

공부/인공지능 2026.11.08