처리량이 0.3%밖에 안 떨어졌습니다. 프록시를 붙이는 대가가 그 정도라고 생각했죠. 아닌 게 정답에 가까웠습니다. 0.3%는 거의 공짜였고, 진짜 어렵기는 뒤에서 생긴 세 가지였습니다.
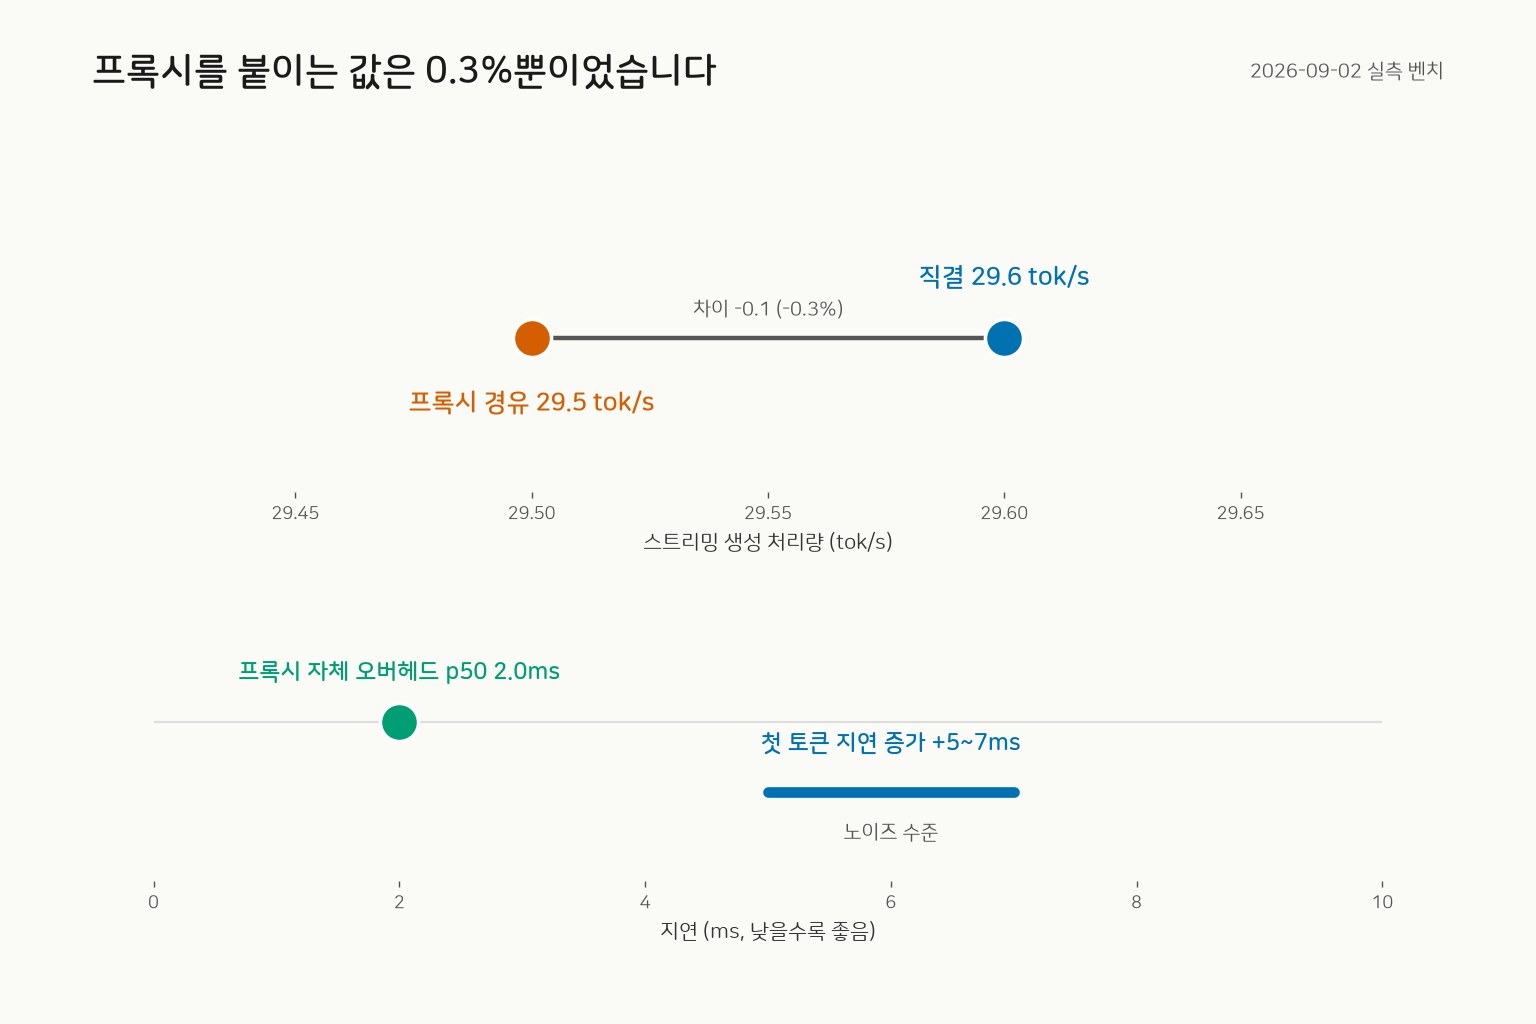
연구실에서 모델을 쓰는 사람들마다 키를 나눠 주고, 누가 얼마를 썼는지 집계하고 싶어졌습니다. vLLM이 기본으로 가진 멀티 키는 인증만 되고 토큰 사용 로그가 남지 않아서, 집계를 하려면 한복판에 프록시를 하나 세워야 했습니다. 붙이기 전 벤치는 선명했습니다. 같은 스트리밍 생성을 직결로 돌리면 29.6 tok/s, 프록시 경유로 돌리면 29.5 tok/s였습니다. 첫 토큰까지 걸리는 시간은 5~7ms 늘었고, 프록시 자체 오버헤드는 응답 헤더로 재니 p50 2.0ms였습니다. 노이즈 수준이라서 그냥 붙였습니다.
0.3%는 진짜였는데, 집계를 잃을 뻔했습니다
첫 번째 문제는 붙인 직후에 드러났습니다. 사용량 집계는 프록시가 Postgres에 남기는 로그가 전부인데, 이 로그에는 프록시를 통과한 요청만 적힙니다. 백엔드 포트가 그 상태로 열려 있으면 아무도 모르게 백문을 통해 들어간 사람이 생기고, 그 트래픽은 대시보드 어디에도 안 나타납니다. 정문을 지키면서 뒷문을 열어두는 격이라서, 집계 숫자 자체가 무의미해집니다.
해결은 백엔드에도 각자의 잠금을 거는 쪽이었습니다. vLLM과 llama.cpp 백엔드마다 서버 전용 키를 주고, 프록시 설정에만 그 키를 넣어두는 식으로요. 키는 두 겹으로 정리됩니다. 사용자 키는 클라이언트에서 프록시까지만 열리고, 서버 키는 프록시에서 백엔드까지만 엽니다. 사용자가 보는 키로는 백엔드에 직접 갈 수 없어야 집계가 성립합니다. 확인은 짧습니다. 키 없이 호출해서 401이 뜨고, 서버 키로 호출해서 200이 뜨면 잠긴 겁니다.
서버가 두 개 뜬 것처럼 보였습니다
두 번째 문제는 로드밸런싱을 위해 백엔드를 재구성하다가 터졌습니다. vLLM 프로세스가 두 개 동시에 살아있는 순간이 있었던 겁니다. pid 2215275와 2215775가 같은 시간에 서로 다른 상태를 들고 돌고 있었습니다. 원인은 슈퍼바이저였습니다. 첫 시도가 아직 모델 로딩 중이라 포트를 여는 단계에 있었는데, 슈퍼바이저는 이게 안 떴다고 판단해서 하나를 더 스폰했습니다. 뒤늦게 뜬 쪽은 포트 충돌로 죽었고, 슈퍼바이저는 그것도 모르고 2216636, 2217888까지 계속 추가했습니다.
여기서 귀찮은 게 로그였습니다. 방금 일어난 충돌만 봐야 할 로그에 며칠 전 오래된 오류가 섞여 나와서, 지금 상태와 지난 상태를 구분하기가 어려웠습니다. 정리하려고 pkill을 걸었는데 ssh 명령어 자체에 패턴 문자열이 포함돼 있어서 pkill이 자기 셸을 죽여버렸습니다. 최종적으로는 PID를 직접 지정해서 하나씩 내리고, GPU 메모리가 비어 있는 것(18MiB)까지 확인한 다음에 수동으로 한 번만 띄웠습니다. 죽음을 막으려고 둔 슈퍼바이저가 중복을 만든 셈이라, 이후에는 서비스 상태를 보기 전에 ps와 ss로 프로세스 개수와 포트 주인부터 확인하는 습관이 생겼습니다.
카드가 사라지는 경로는 세 갈래였습니다
세 번째 문제가 가장 넓었습니다. 프록시 앞의 모델 카드가 사라지는 경우가 여러 형태로 나타났는데, 겉보기엔 전부 장애였지만 속은 전부 설정이었습니다.
| 증상 | 원인 | 해결 |
|---|---|---|
| 모델 추가가 500으로 거절 | Admin API가 기본 차단 | 설정 파일 수정 후 컨테이너 재시작 |
| 등록했는데 목록에 안 보임 | 가상 키의 허용 모델 제한 | 키 제한을 비워서 해제 |
| 기동 직후 목록이 통째로 빈 상태 | 컨테이너 안의 127.0.0.1 | 호스트 IP로 교체 |
첫 번째는 마스터 키로 런타임 모델 추가를 시도했을 때 돌아왔습니다. 인증은 통과하는데 저장 기능 자체가 기본으로 꺼져 있다는 500이 뜨는 겁니다. 환경변수 하나만 켜면 되는데, 켜지 않는 이상 설정 파일을 고치고 컨테이너를 재시작하는 길이 유일한 방법이 됩니다. 다른 관리 조회는 다 되는데 추가만 안 되니, 한쪽만 반쯤 고장 난 것처럼 읽힙니다.
두 번째는 서버 설정에 모델을 분명히 넣었는데도 모델 목록 조회에서 안 보이는 경우였습니다. 호출을 시도하면 이 키는 특정 모델만 쓸 수 있다는 403이 뜹니다. 목록을 돌려주는 두 개의 조회 API가 전부 요청 키 기준으로 필터링되고 있어서, 서버 상태를 확인하는 용도로는 쓸 수가 없었습니다. 발급된 키 목록에서 각 키의 허용 모델을 조회해보니 제한이 걸려 있었고, 제한을 비우는 갱신 하나만으로 바로 풀렸습니다. 이쪽은 컨테이너 재시작도 필요 없었습니다.
세 번째는 실수라고 말하기에도 민망한 기초였습니다. 프록시는 살아있는데 모델 목록이 비어 있는 현상인데, 로그를 보니 데이터베이스에 닿지 못하고 있었습니다. 컨테이너 안에서 127.0.0.1은 자기 자신을 가리키기 때문에, 호스트에 올라간 Postgres로 가는 길로 127.0.0.1을 적으면 절대 못 만납니다. 연결 문자열을 호스트 IP로 바꾸자 목록이 바로 채워졌습니다.
그리고 000은 죽은 서버가 아니었습니다
같은 사건의 여파로 하나를 더 배웠습니다. 백엔드가 특정 사내 IP로만 수신하고 있었는데, 다른 이름으로 프로브를 날리면 연결 실패(000)가 뜹니다. 이 숫자만 보면 서버가 죽었다고 읽기 좋은데, 실제로는 서버가 멀쩡했습니다. 수신 주소 자체를 ps와 ss로 확인해서 정확한 주소로 불러보니 조용히 200이 돌아왔습니다. 반대로 200이 떠도 실제 생성이 되는지 한 번은 왕복해봐야 한다는 것도 같은 라인에서 배웠습니다. 프로브는 서버 상태만 말해주는 게 아니라, 내 주소가 맞는지까지 같이 말해주는 겁니다.
0.3%가 말해주지 않은 것
프록시는 성능을 안 깎는다는 건 사실로 남았습니다. 대신 배선 정합성을 요구했는데, 백엔드 잠금을 빼먹으면 집계가 허상이 되고, 로그를 한쪽 렌즈로만 보면 중복 기동을 놓칩니다. 아직 손이 남은 지점은 라우팅 상태입니다. 가중치가 높은 백엔드가 이틀 정도 죽어있으면, 그 뒤 살아나도 프록시를 재시작할 때까지 트래픽이 거기 들어가지 않는 걸 관찰했습니다. 재시작 직후에는 지연 이력이 초기화되어서 한쪽으로 몰리는 현상도 확인했고요. 매 재시작 이후 집계의 배포 분포를 확인하는 절차가 붙은 게 그 때문이고, 이 확인을 자동화하는 게 다음 과제입니다.
'공부 > 인공지능' 카테고리의 다른 글
| 수업 챗봇 QA를 자동으로 증식시켰는데 아무것도 안 늘었습니다 (0) | 2026.11.09 |
|---|---|
| 백업 모델로 갈아탔더니 3배 느려졌습니다 — 웜그래프가 거짓말한 130ms (0) | 2026.11.08 |
| 5일 연속 크론 4개가 죽었는데 알림은 0건이었습니다 (0) | 2026.11.07 |
| 살아 있다고 말하는 것들 — active·exit 255·CPU 99.9%가 전부 거짓말이었습니다 (0) | 2026.11.06 |
| 87쪽 연구보고서를 기계에 검토시켰더니 27군데가 나왔습니다 (0) | 2026.11.05 |