TechToast

  • 홈
  • 태그
  • 미디어로그
  • 위치로그
  • 방명록

kvm64 1

L40 3장이 워크스테이션 1장보다 느립니다 — CPU가 AVX2 없는 kvm64였습니다

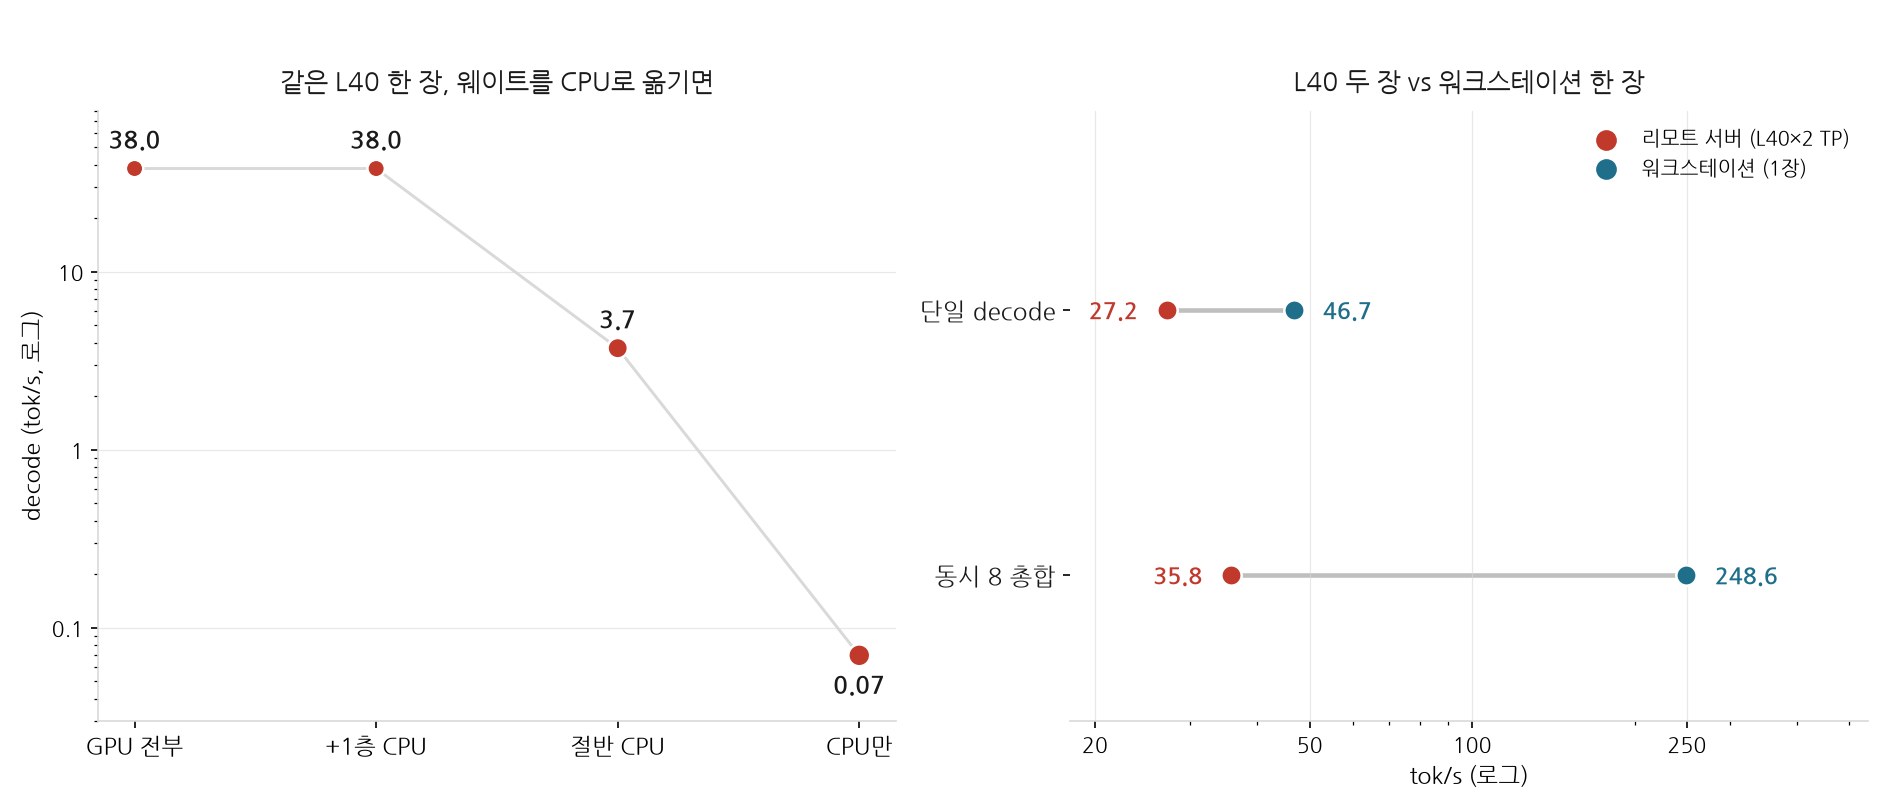
단일 디코드 27.2 tok/s. 리모트 서버를 같은 벤치 스크립트로 다시 돌려본 결과입니다. GPU 카드 한 장뿐인 워크스테이션에서 같은 조건으로 재보니 46.7이 나왔습니다. 리모트 서버는 L40 세 장이 올라간 기계이고, 워크스테이션은 PRO 6000 96GB 한 장입니다. 카드 수에서도, 총 VRAM(48GB×3, 합계 144GB)에서도 리모트가 이기는데 속도에서 졌습니다. 병목은 GPU가 아니었습니다.같은 조건으로 재측정하니 차이가 드러났습니다감으로 비교한 것이 아닙니다. 같은 27B 모델을 두 기계에 같은 스크립트로 돌리고 숫자를 나란히 세웠습니다. 왼쪽 열은 L40 두 장을 Tensor Parallel로 묶어 돌리는 현행 프로덕션이고, 오른쪽 열은 카드 한 장에 NVFP4 양자화와 DFLAS..
공부/인공지능 2026.11.04
이전
1
다음
더보기
프로필사진

TechToast

가랑비에 옷 젖듯 글쓰기.

  • 분류 전체보기 (100) N
    • 공부 (65) N
      • 의료영상처리 (0)
      • 인공지능 (59) N
      • 텍스트 (1)
      • 잡소리 (5)
    • 리뷰 (25)
      • 제품 (11)
      • 여행 (0)
      • 기타 (14)
    • 모디아 프로젝트 (6)

Tag

모니터링, 크론, 트러블슈팅, 세컨드브레인, 로컬 LLM, LiteLLM, LLM, 벤치마크, 메모리, 헤르메스, LLM서빙, 오픈웨이트, 음성AI, Rag, vllm, ai 에이전트, deepseek, llama.cpp, DGXSpark, HERMES,

최근글과 인기글

  • 최근글
  • 인기글

최근댓글

공지사항

페이스북 트위터 플러그인

  • Facebook
  • Twitter

Archives

Calendar

«   2026/11   »
일 월 화 수 목 금 토
1 2 3 4 5 6 7
8 9 10 11 12 13 14
15 16 17 18 19 20 21
22 23 24 25 26 27 28
29 30

방문자수Total

  • Today :
  • Yesterday :

Copyright © Daum Corp. All rights reserved.

티스토리툴바