gb10 2

잡으려고 켜둔 감시자가 서비스를 죽였다 — GB10 통합메모리에서 earlyoom이 vLLM을 킬한 하루

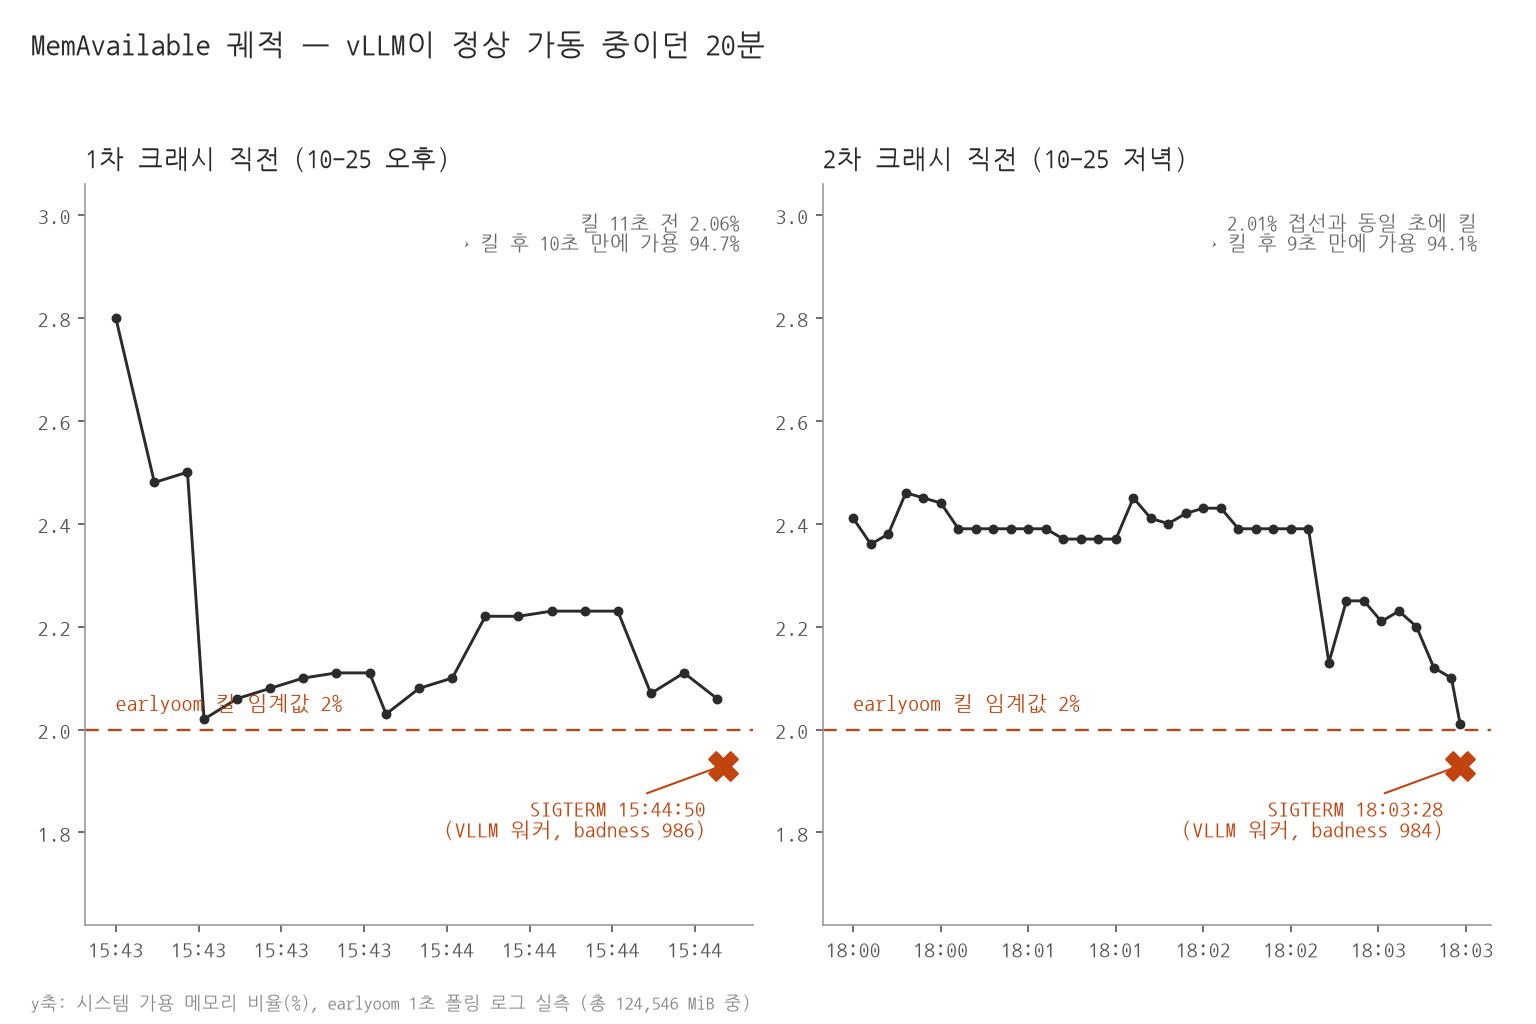
2026-10-25, GB10 듀얼(128GB 통합메모리를 나누는 두 노드에서 vLLM 1M 컨텍스트를 서빙 중)에서 서비스가 낮에 두 번, 저녁에 한 번 죽었습니다. 부팅 후 6일 넘게 아무 탈 없이 돌던 스택인데, 그날 코드도 모델도 설정도 한 줄 건드리지 않았습니다. GPU 연산 오류도 모델 오류도 흔적이 없었어요. 범인은 메모리를 지키려고 켜둔 감시 데몬 earlyoom이었습니다. NVIDIA 공식 셋업이 기본으로 넣어준 녀석이에요. earlyoom의 일은 단순합니다. 가용 메모리가 2% 아래로 떨어지면 "나쁜 점수(badness)"가 가장 높은 프로세스를 먼저 끝내는 것. 메모리를 지키는 파수꾼이고, 보통 기계에서는 아주 합리적인 선입니다. 그런데 통합메모리 머신에서는 그 2%가 평상시 가동 영..
공부/인공지능 2026.11.03

DeepSeek 1017을 2대의 GB10에 돌리다 — TensorFold와 1M 컨텍스트의 실체

한 줄 요약부터. DeepSeek의 새 모델 '1017'(V4.1-Flash-1017)을 우리 GB10 두 대에 EXL3 2.9bpw 포맷으로 올려서 서빙 엔진을 바꿔가며 실측했습니다. TensorFold가 디코드는 vLLM보다 1.6배 빨랐는데, 커뮤니티에서 돌던 2.1~2.3배 주장 그대로는 재현되지 않았습니다. 우리가 느려서가 아니라 기준선이 빨랐습니다. 그리고 이번 실험에서 제일 중요한 걸 하나 확정했는데, 모델 카드에 적힌 1M과 두 대가 실제로 주는 1M은 다른 문장이라는 점입니다. 1017이 어떤 모델이고, 어떻게 올렸나1017은 10월 17일에 나온 DeepSeek V4.1-Flash-1017입니다. 모델 카드가 발표한 주요 수치로는 Terminal-Bench가 직전 버전의 31.2에서 4..

공부/인공지능 2026.10.20