LiteLLM 3

모델은 256K인데 자꾸 128K로 나온다 — 로컬 LLM 컨텍스트 길이 함정

모델은 256K인데 자꾸 128K로 나온다 — 로컬 LLM 컨텍스트 길이 함정같은 모델을 쓰는데 어떤 세션에선 128K로, 또 어떤 세션에선 256K로 인식되는 일이 있었습니다. 모델이 바뀐 것도 아니고, 설정이 꼬인 것도 아닙니다. 클라이언트가 최대 컨텍스트 길이를 알아내는 방식에 구멍이 있었습니다. 원인과 해결 방법을 정리해 봅니다. 같은 모델인데 세션마다 다르게 보인다모델을 직접 붙이는 대신 프록시를 거쳐 여러 모델을 붙여 쓰는 구성입니다. 그래서 실제 최대 컨텍스트 길이가 262,144(256K)인 모델을 두고도, 세션에 따라 128K로 잡히는 일이 생겼습니다. 모델 스펙은 그대로인데 클라이언트가 "이 모델은 131,072까지"라고 알고 있는 셈이죠. 그 모델을 처음 붙였을 때부터 256K로 잘 ..
공부/인공지능 2026.10.06

모델은 256K인데 자꾸 128K로 나온다 — 로컬 LLM 컨텍스트 길이 함정

모델은 256K인데 자꾸 128K로 나온다 — 로컬 LLM 컨텍스트 길이 함정같은 모델을 쓰는데 어떤 세션에선 128K로, 또 어떤 세션에선 256K로 인식되는 일이 있었습니다. 모델이 바뀐 것도 아니고, 설정이 꼬인 것도 아닙니다. 클라이언트가 최대 컨텍스트 길이를 알아내는 방식에 구멍이 있었습니다. 원인과 해결 방법을 정리해 봅니다. 같은 모델인데 세션마다 다르게 보인다모델을 직접 붙이는 대신 프록시를 거쳐 여러 모델을 붙여 쓰는 구성입니다. 그래서 실제 최대 컨텍스트 길이가 262,144(256K)인 모델을 두고도, 세션에 따라 128K로 잡히는 일이 생겼습니다. 모델 스펙은 그대로인데 클라이언트가 "이 모델은 131,072까지"라고 알고 있는 셈이죠. 그 모델을 처음 붙였을 때부터 256K로 잘 ..
공부/인공지능 2026.10.06

27B 로컬 LLM을 vLLM → llama.cpp로 갈아끼우며 동시성·속도 끌어올리기

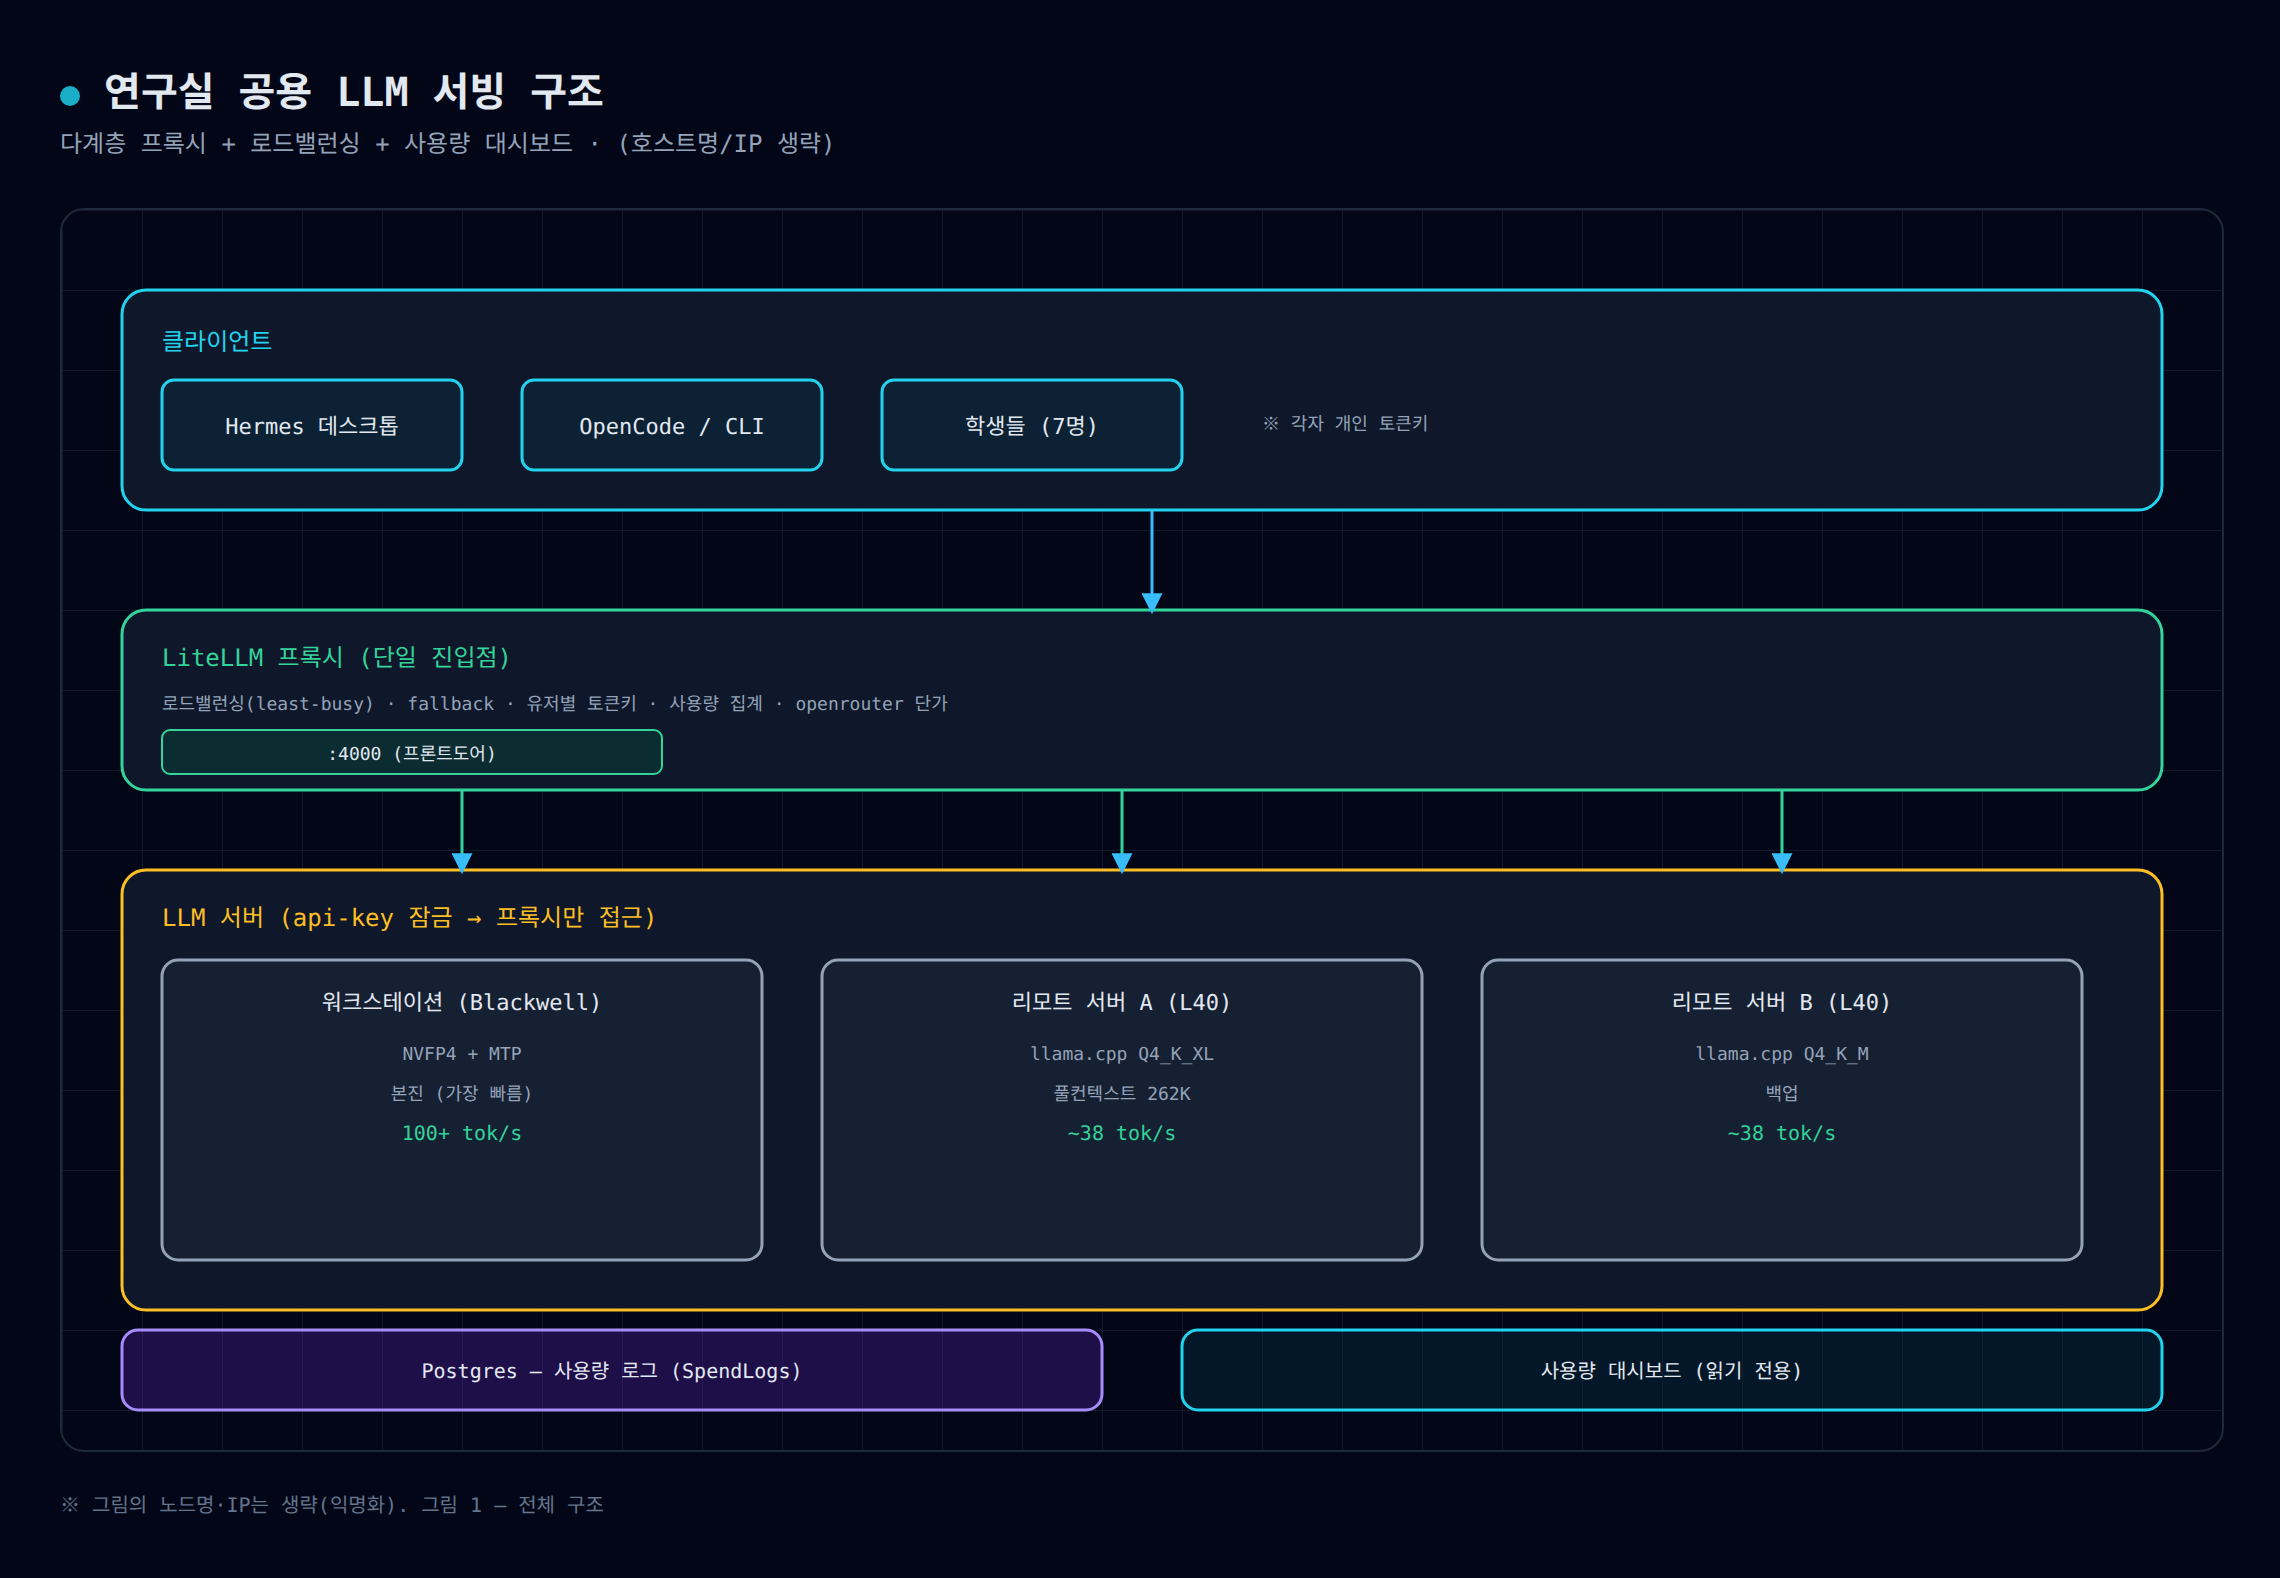
연구실에 공용 LLM 서버를 돌리면서 생긴 일입니다. 27B짜리 dense(hybrid linear-attn) 모델을 워크스테이션과 리모트 서버에 올려서, 교수와 학생 7명이 매일같이 붙들고 썼는데, 문제가 하나 있었습니다. vLLM으로 FP8 양자화를 걸면 안정적이긴 한데 응답 속도가 아쉽고, 요청이 몰리면 속도가 급격히 떨어졌습니다. 그래서 저는 하드웨어를 더 사는 대신, 서빙 레이어만 통째로 바꾸는 쪽을 택했습니다. 왜 갈아탔나 — vLLM의 벽vLLM은 정말 잘 만들었습니다. 다만 이 모델이 hybrid linear-attention 구조라서, 카드 세 장을 TP=3으로 한 덩어리로 묶는 게 애초에 안 됩니다. "16 not divisible by 3"이라는 에러가 뜨면서 죽네요. 그래서 TP=2..

공부/인공지능 2026.09.09