DeepSeek 1017을 2대의 GB10에 돌리다 — TensorFold와 1M 컨텍스트의 실체
한 줄 요약부터. DeepSeek의 새 모델 '1017'(V4.1-Flash-1017)을 우리 GB10 두 대에 EXL3 2.9bpw 포맷으로 올려서 서빙 엔진을 바꿔가며 실측했습니다. TensorFold가 디코드는 vLLM보다 1.6배 빨랐는데, 커뮤니티에서 돌던 2.1~2.3배 주장 그대로는 재현되지 않았습니다. 우리가 느려서가 아니라 기준선이 빨랐습니다. 그리고 이번 실험에서 제일 중요한 걸 하나 확정했는데, 모델 카드에 적힌 1M과 두 대가 실제로 주는 1M은 다른 문장이라는 점입니다.
1017이 어떤 모델이고, 어떻게 올렸나
1017은 10월 17일에 나온 DeepSeek V4.1-Flash-1017입니다. 모델 카드가 발표한 주요 수치로는 Terminal-Bench가 직전 버전의 31.2에서 42.3으로 뛰었고, DeepSWE에서도 상위권, 환각 저지와 지식 축에서 개선이 확인됐다고 합니다. 우리 환경에서는 EXL3 2.9bpw 양자화로 받아서 43개 샤드로 쪼개 GB10 두 대(DGX Spark)에 TP2로 얹었고, 노드 간 all-gather는 RoCE(ConnectX-7)가 담당합니다.
가중치는 하나이고 서빙 엔진만 다릅니다. 같은 2×GB10, 같은 EXL3 2.9bpw 가중치 위에 기존 vLLM 키트와 새로 갈아끼운 TensorFold(MiaAI/LibertAIDAI의 커뮤니티 레시피), 참고군으로 Qwen3.8-Flash-Next(1M)까지 세 줄을 세웠습니다.
같은 가중치, 다른 엔진 — 1.6배와 재현되지 않은 것
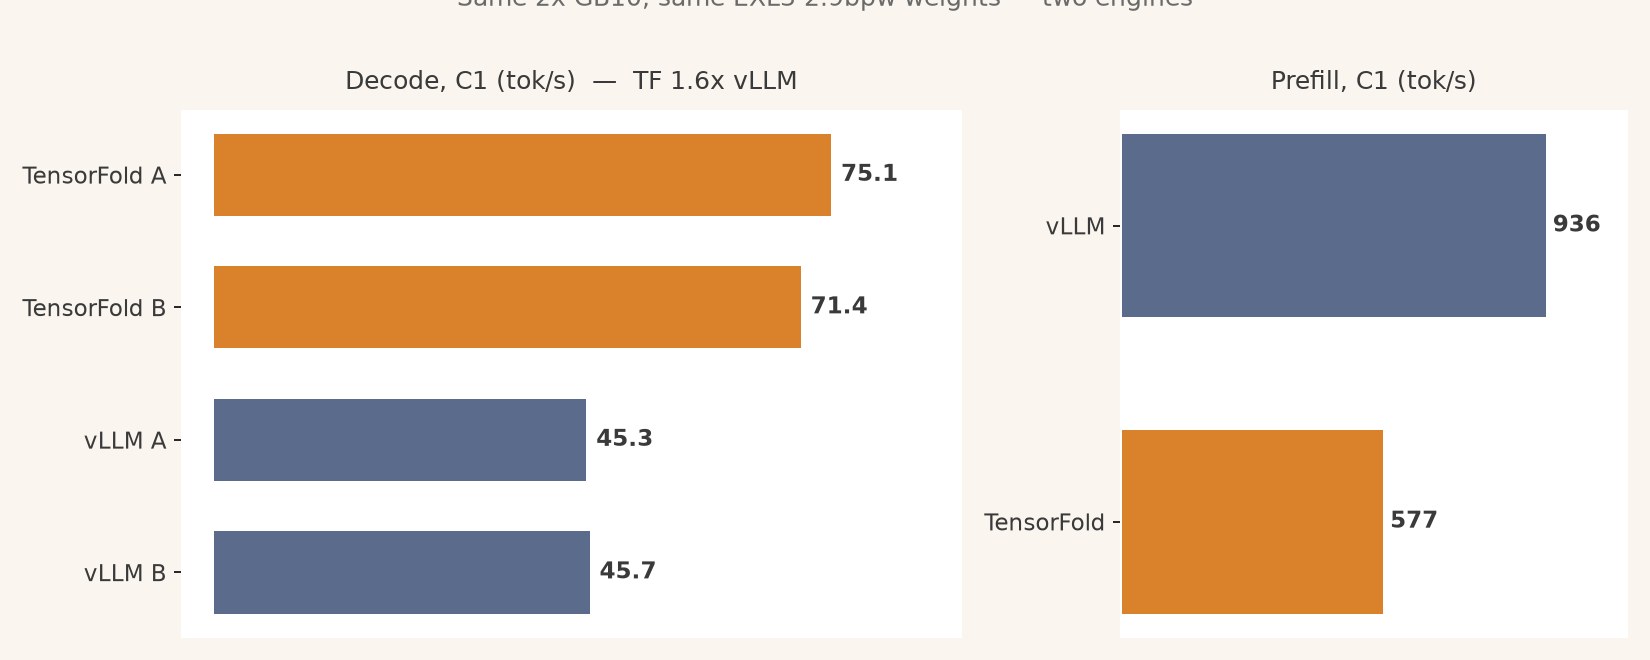
디코드는 TensorFold가 두 번 런에서 75.1과 71.4 tok/s, vLLM이 45.3과 45.7 tok/s였습니다. 배율로 1.6배입니다. NVIDIA 포럼과 Reddit에서 TensorFold가 vLLM 대비 2.1~2.3배라는 실측 post들이 돌았는데 우리 환경에서는 재현되지 않았습니다. 원인을 짚어보니 상대는 기준선 vLLM 디코드가 27 tok/s쯤이었고 우리는 이미 45 tok/s로 빨랐습니다. 벤치 배율은 기준선과 함께 읽어야 한다는 걸 이번 실측으로 배웠습니다.
프리필은 반대로 vLLM이 936 tok/s, TensorFold가 577 tok/s로 항상 우위였습니다. 커뮤니티의 '프리필 역전'도 재현되지 않았어요. 긴 문서를 씹어 넣는 일이 중심이면 엔진 선택이 달라져야 한다는 뜻입니다. TensorFold의 진짜 값어치는 속도보다 구조에 있었어요. vLLM 키트는 MAX_NUM_SEQS가 2인데 TensorFold는 8슬롯이고, 요청당 컨텍스트도 vLLM은 600K 상한인 데 반해 TensorFold는 기본 262K에서 1M으로 바꿀 수 있습니다. 여러 에이전트가 각자 세션을 돌리는 동시성 구조에는 후자가 훨씬 잘 맞았습니다.
'1M'의 실체 — 풀과 요청은 별개다
기동 로그의 한 줄을 주의해서 봐야 합니다.
8 slot(s) x 1048640 tokens; pool 4096 pages free
'슬롯당 1M이 8개면 8M 아니냐'로 읽히는데 구조가 다릅니다. 풀(pool)은 RAM에 할당된 KV 캐시의 총량(fp8, 2노드 합산)이고, 4096 페이지 × 256 토큰이 모여 1M입니다. 요청당 컨텍스트는 슬롯 하나의 상한이고요. 저수조와 수도꼭지, 밸브가 두 개인 셈이죠. 이 둘을 혼동하면 1M이 '실제로는 못 쓰는 숫자'로 읽히지만, KV는 풀에서 on-demand로 뽑히기 때문에 '1M 세션 하나 + 짧은 세션 여러 개'가 성립합니다. 우리 실험실 에이전트 워크로드는 0.85 지점 압축 구조가 중심이라 라이브 컨텍스트 중앙값이 45K, 200K 미만 콜이 61.5%이고, 요청당 상한 1M은 거의 안 닿습니다.
안 되는 것도 분명합니다. 풀 총량이 1M급이면 1M 세션 하나가 여유 0이고, 둘은 이론적으로도 초과입니다. 이 경계는 노드당 RAM 여유 8~9GiB에서 정해져서 설정 한 줄로는 넓어지지 않습니다. 모델이 1M을 지원한다는 말과 두 대가 1M을 실용적으로 주느냐는 문장은 다르다는 것, 이번 실험이 남긴 가장 실용적인 결론입니다.
성격 판정 — 로컬 벤치가 만점이라 외부 평가로
환각·리콜·툴콜 로컬 벤치에서는 1017도 Qwen3.8-Flash-Next도 나란히 만점(10/10)이 나와서 두 모델을 가려낼 수 없었습니다. 그래서 Artificial Analysis의 독립 측정을 받았습니다. 지능지수는 39 vs 40으로 차이 1점, 실질적 동급인데 성격은 꽤 갈립니다. Qwen 쪽은 지식업무와 문서에 강하고, 1017 쪽은 자동화를 가져갔어요. 자동화 서브스코어 69 vs 56, 환각저항 Omniscience −5 vs −10, 롱컨텍스트 추론 LCR 84% vs 80%가 모두 1017 우위로 나왔습니다. benchlm 통합(10/17 기준)도 코딩 60.8 vs 46.6, HLE 42.6% vs 30.8%로, 90% 구간은 겹치지만 코딩과 지식 축에서는 1017이 눈에 띄게 앞섭니다.
승격과, 남은 아쉬움
결국 1017 + TensorFold + 요청당 1M 상한 조합으로 메인 서빙을 승격했습니다. 자동화·터미널 워크로드에 성격이 맞고, 8슬롯 구조가 동시 세션을 받아줍니다.
남은 아쉬움은 풀 총량입니다. 1M급 풀은 두 대의 RAM에 매여 있어서 '1M 세션을 실제로 두 개'는 물리적으로 불가합니다. GB10이 네 대 오면 64개 어텐션 헤드를 TP4로 균등 분할하면서 2M급 풀이 성립하는 지점이 옵니다. 세 대는 애매해요. 64가 3으로 안 나누고 hidden 5120도 마찬가지라 TP3은 아키텍처 차원에서 불가입니다. 그래서 세 번째가 오면 승분이 아니라 스페어 아니면 별도 모델 노드로 씁니다. 네 번째를 부를 때까지의 과제로 남겨둡니다.