도비비 '잔혹한 천사의 테제' 번안, 일본어 원곡과 몇 % 같은 소리인가 — 음절 380개 뽑아 재봤다
도비비의 '잔혹한 천사의 테제' 한국어 번안을 듣다가, 왜 이렇게 원곡 일본어랑 발음 간격이 좁을까 싶어서 가사 두 개를 나란히 놓고 음절을 하나하나 분해해봤습니다.
결론부터 — 같은 자리에 같은 자음이 올 확률은 낮지만, 발음의 '재질'(분포)은 91% 일치합니다. 그 차이가 '번안'과 '원곡 같은 소리'를 가릅니다.
왜 이 곡인가
이 곡은 '잔혹한 천사의 테제', 1995년 고바야시 요코(高橋洋子)가 부른 에반게리온의 오프닝입니다. 일본 애니메이션을 한번 지나친 사람이라면 첫 소절에서 어깨를 들썩였을 법한 멜로디인데, 그 위에 한국어 가사를 얹은 버전이 도비비(CANDID MUSIC)의 번안입니다. 도비비가 Vocal & Lyric Adaptation을 맡았고, 들을수록 "한국어·일본어 발음 간격을 최소화했다"는 인상을 받습니다. 그 인상이 숫자로도 확인되는지, 가사만 놓고 재봤습니다.
어떻게 재봤나
원곡 일본어 가사(uta-net 9307)와 번안 한국어 가사(유튜브 공식 설명문)를 19개의 musical-phrase 단위로 나란히 정렬했습니다. 일본어는 한자에서 히라가나를 거쳐 모라로, 한국어는 자모(자음+모음)로 하나하나 분해했어요. 그리고 세 가지 지표로 견줬습니다.
하나는 자음 위치 일치, 하나는 모음 위치 일치, 마지막은 타격음(강음) 패턴 일치입니다. 여기에 위치를 무시하고 곡 전체의 소리를 한 바구니에 담았을 때의 분포(텍스처) 유사도까지 재봤습니다. "같은 자리에 같은 소리가 오는가"와 "쓰이는 소리의 비율 자체가 같은가", 이 두 갈래를 함께 보는 셈입니다.
결과 수치
먼저 전체 규모입니다. 원곡은 384모라, 번안은 377음절로 거의 1:1에 가깝고, 음절 길이비는 0.98이었습니다. 길이부터 원곡에 맞춰져 있는 겁니다.
그런데 "같은 자리에 같은 소리"로 겨우면 얘기가 다릅니다. 자음 위치 일치는 14%, 모음 위치 일치는 20%에 그쳤고, 타격음(강음) 패턴 일치 60%까지 합쳐 위치대조 종합은 38%였습니다. 무작위로 재배열해 견준 결과(p=0.114)와 비교하면 타격음은 우연(50%)보다는 확실히 높지만, 위치는 "딱 맞춘" 수준은 아니었습니다.
반면 분포로 보면 판이 바뀝니다. 자음 분포 cosine 유사도 89%, 모음 분포 cosine 94%로, 위치를 무시한 "재질" 유사도는 91%에 이릅니다. 위치 50%와 텍스처 50%를 섞은 최종 종합은 65%였습니다.

왜 비슷하게 들리는가
여기서 핵심 반전이 나옵니다. 비슷하게 들리는 이유가 "같은 자리에 같은 소리"가 아니라는 점입니다. 위치 대조는 38%로 낮은데, 그 소리의 재질(분포)은 91%나 일치합니다. 개별 음절의 배치를 겨우면 빗나갔지만, 곡 전체에서 쓰이는 소리의 구성비는 거의 겹친다는 뜻입니다. 몇 개 음소의 위치가 아니라, 곡이 어떤 음색으로 채워져 있는가가 같다는 거죠.
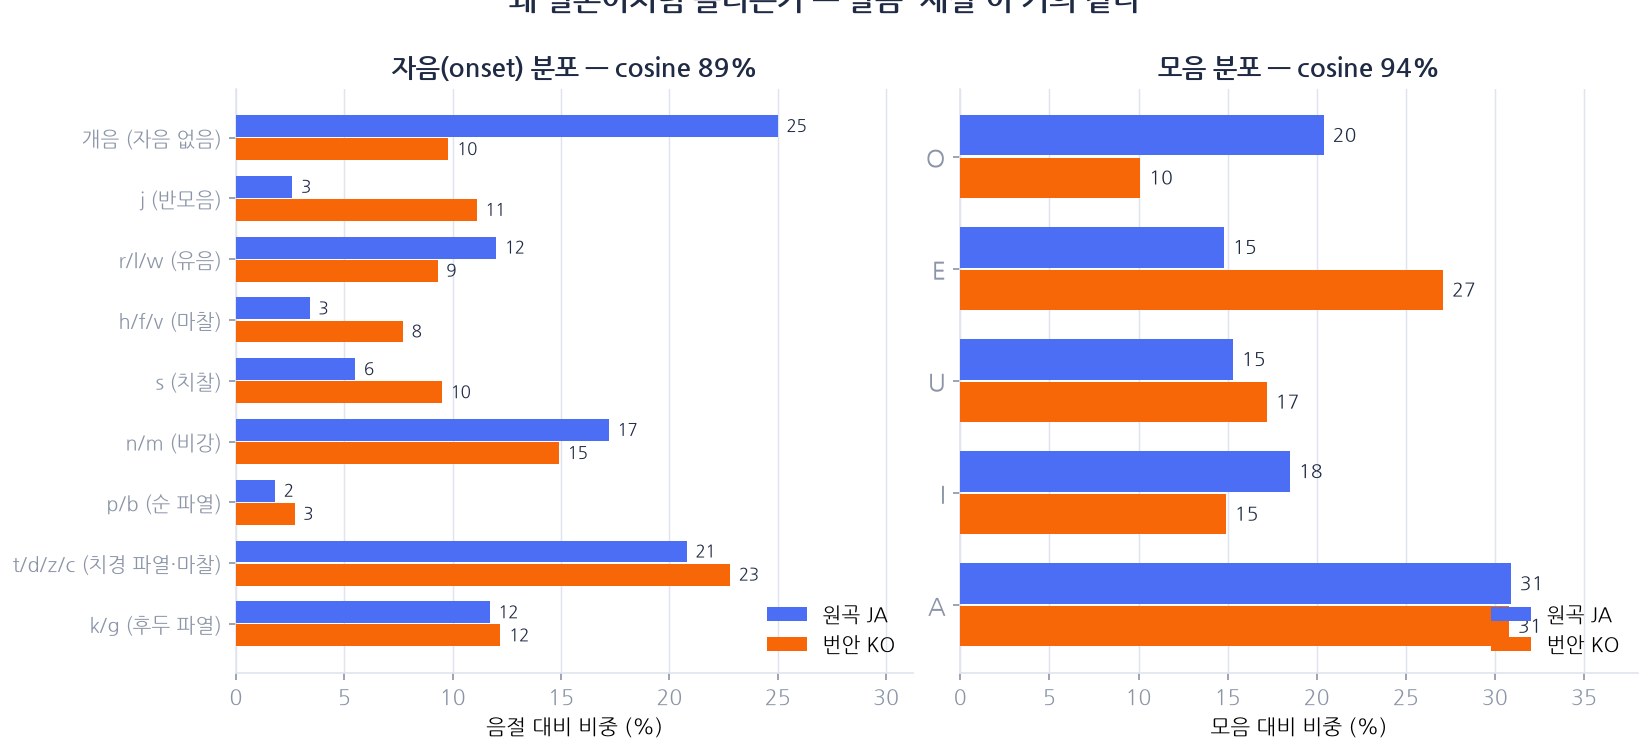
모음 분포가 가장 뚜렷합니다. 원곡의 a모음은 30.9%, 번안은 30.8%로 사실상 같습니다. 곡 전체를 도는 모음의 색깔 비중이 여기까지 맞아떨어진 것입니다. i와 u도 18.5% 대 14.9%, 15.3% 대 17.2%로 가까운 반면, e와 o는 번안이 e쪽으로 쏠립니다(14.8%→27.1%, 20.4%→10.1%). 그래서 모음 94%가 높지만 "완전"은 아닙니다.
자음도 비슷합니다. 후두파열(k/g) 11.7% 대 12.2%, 치경계(t/d/z/c) 20.8% 대 22.8%로 거의 겹치지만, 한국어는 자음 없는 개음이 25.0%에서 9.8%로 확 줄어듭니다. 한국어가 자음 onset을 더 많이 쓴다는 뜻이고, 이 점이 일본어와의 미묘한 음색 차이를 만듭니다. 곡 전체를 놓고 보면 "있는 소리 비율"은 비슷한데, 소리가 끼어드는 방식은 조금 달랐습니다.
제목 한 줄, 그리고 솔직한 한계
정말 많이 듣는 그 한 줄, '잔혹한 천사의 테제'도 흥미롭습니다. 원곡은 残酷な天使のテーゼ = za-n-ko-ku-na-te-n-shi-no-te-te-ze(12모라), 번안은 '잔혹한천사의테제'(8음절)입니다. 첫 음절 '잔'(z/j)은 원곡 'za'의 치경 마찰 자음과 a모음이 완전히 겹칩니다. 이 첫 소절이 곡 전체 인상을 좌우한다고 볼 수 있습니다. 다만 12모라를 8음절로 압축하면서(길이비 0.67) 제목은 음절이 줄어듭니다.
그리고 정직하게 적자면, 이 분석은 가사 텍스트 차원의 결론입니다. 실제 음향(피치·타이밍·음색 형상)은 분석하지 않았습니다. "발음이 비슷하다"는 것은 곡에 얹힌 자음·모음 구성이 비슷하다는 뜻이지, 실제 소리가 같다는 뜻은 아닙니다. 정렬도 멜로디 구간에 맞춰 수동으로 잡은 휴리스틱이라 모라와 음절의 1:1 대응은 완벽하지 않습니다. 그런데도 위치 일치 14%가 낮은 반면 분포 91%가 높다는 이 차이는, 흩어진 소리가 아니라 곡의 "재질"이 같다는 점을 말해줍니다. 이 수치들은 소재 디렉터리의 analyze.py로도 그대로 재현할 수 있습니다.