모델은 256K인데 자꾸 128K로 나온다 — 로컬 LLM 컨텍스트 길이 함정
모델은 256K인데 자꾸 128K로 나온다 — 로컬 LLM 컨텍스트 길이 함정
같은 모델을 쓰는데 어떤 세션에선 128K로, 또 어떤 세션에선 256K로 인식되는 일이 있었습니다. 모델이 바뀐 것도 아니고, 설정이 꼬인 것도 아닙니다. 클라이언트가 최대 컨텍스트 길이를 알아내는 방식에 구멍이 있었습니다. 원인과 해결 방법을 정리해 봅니다.
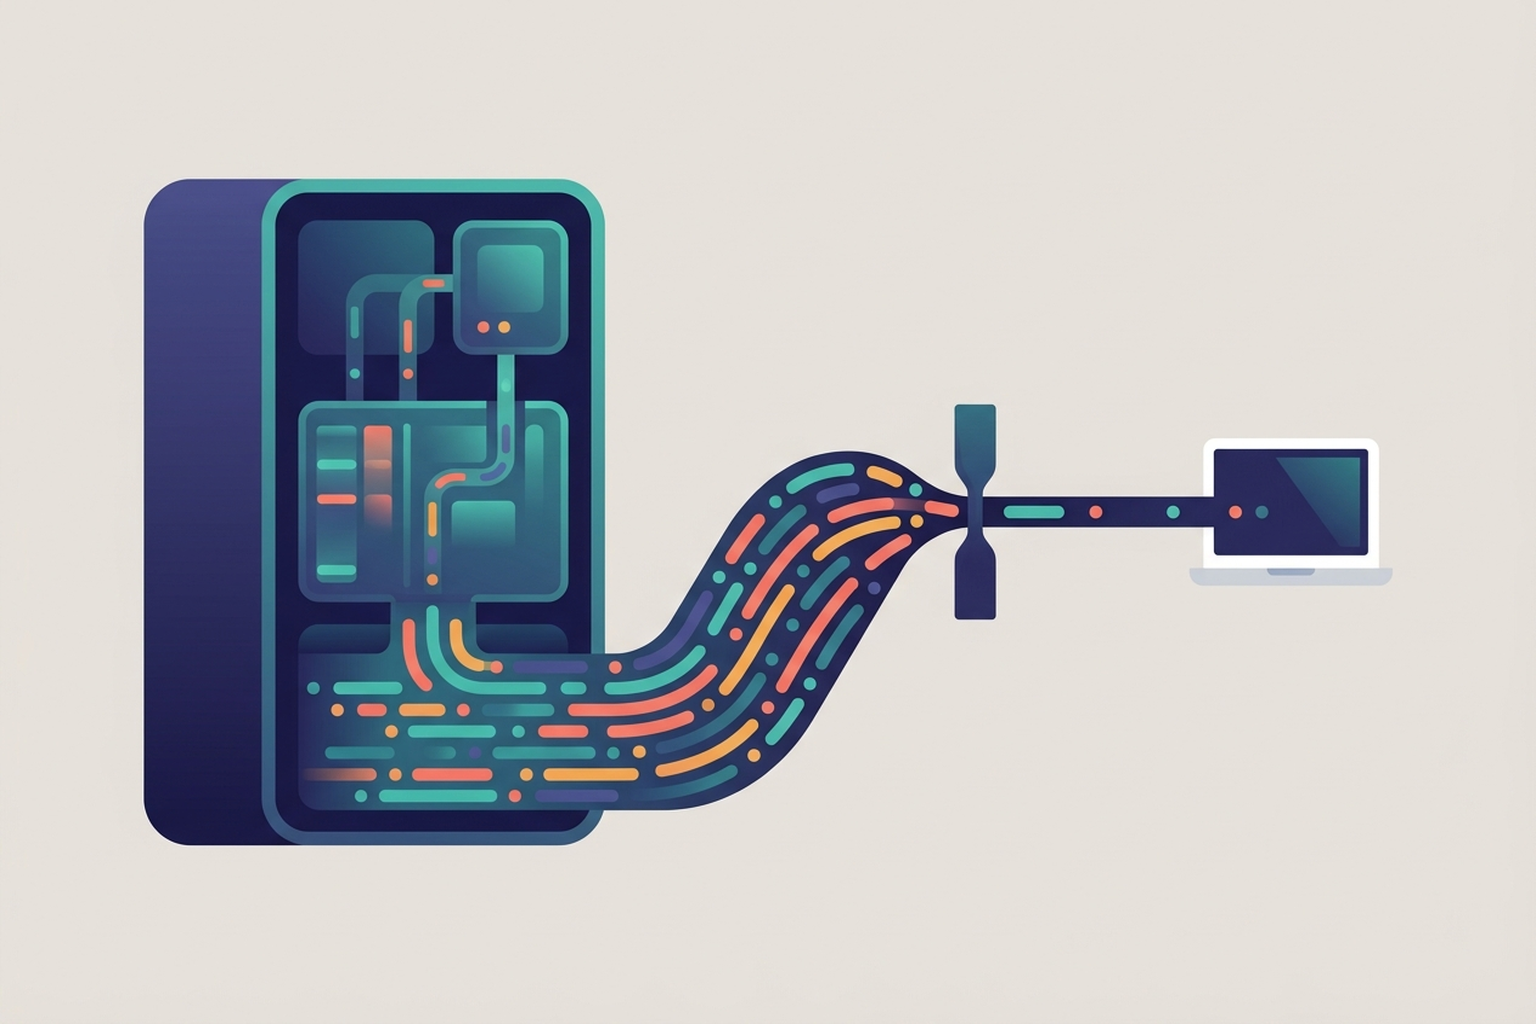
같은 모델인데 세션마다 다르게 보인다
모델을 직접 붙이는 대신 프록시를 거쳐 여러 모델을 붙여 쓰는 구성입니다. 그래서 실제 최대 컨텍스트 길이가 262,144(256K)인 모델을 두고도, 세션에 따라 128K로 잡히는 일이 생겼습니다. 모델 스펙은 그대로인데 클라이언트가 "이 모델은 131,072까지"라고 알고 있는 셈이죠. 그 모델을 처음 붙였을 때부터 256K로 잘 잡혔던 터라, 어느 순간부터 반 토막이 난 걸 보고 당황할 수밖에 없었습니다.
원인: 프록시의 /v1/models가 max_model_len을 안 준다
클라이언트는 모델의 최대 길이를 알려면 프록시의 /v1/models 응답을 봐야 합니다. 그런데 이 프록시가 내보내는 응답에는 max_model_len 필드가 없었습니다.
클라이언트(리졸버)는 길이를 알아내기 위해 두 가지 경로를 둡니다. 먼저 실제로 물어보는 라이브 프로브가 있고, 그것이 실패하면 하드코딩된 카탈로그의 모델명별 값으로 폴백합니다. 프록시가 정답을 안 주니 라이브 프로브가 실패하고, 폴백 경로가 도는 것인데, 문제는 카탈로그의 모델명 catch-all 값이 131,072(128K)로 걸려 있었다는 점입니다. 모델 스펙은 256K인데 인식은 128K였습니다.
일상 비유로 풀면, 식당에서 "오늘 코스가 256K짜리인가요?" 하고 물었는데 웨이터가 메뉴판을 안 내미는 상황입니다. 손님이 기다리다 빈손으로 돌아오니, "저 지난번에 봤던 메뉴가 128K짜리였지" 하고 기억에 의존해 버리는 겁니다. 실제 주방은 256K 코스를 충분히 내고 있는데도요.
context_length를 명시적으로 고정한다
접근은 프로바이더 설정의 해당 모델 항목에 context_length를 명시해 주는 것입니다. 이러면 라이브 프로브의 성공 여부나 카탈로그 폴백과 무관하게 클라이언트가 항상 정확한 값을 사용합니다. 빈손으로 돌아온 웨이터에게 의존할 이유가 없어진 셈입니다.
models:
  <모델명>:
    context_length: 262144
검증과 한계
패치 후 리졸버를 다시 실행하니 인식 값이 131,072에서 262,144로 바뀌었습니다. 다른 모델 경로에는 아무 영향이 없었습니다.
다만 이 해법은 조용한 실패를 명시적 고정으로 바꾼 것일 뿐, 근본 수리까지는 아니었습니다. 클라이언트가 모델 스펙을 모를 때 카탈로그에 의존하는 구조라서, 모델이 늘어날 때마다 수동 고정이 하나씩 필요합니다. 가장 깔끔한 해법은 그 프록시가 /v1/models 응답에 max_model_len을 노출하도록 고치는 것이지만, 당장은 모델별 고정이 가장 안전하고 확실했습니다. 이번에 256K 모델을 이렇게 잡아 두면 됩니다.