[세컨드브레인 개발기] 14. GB10 에서 배운 것 — 속도는 대역폭을 활성 파라미터로 나눈 값이다
[세컨드브레인 개발기] 14. GB10 에서 배운 것 — 속도는 대역폭을 활성 파라미터로 나눈 값이다
이 시리즈의 3부는 에이전트가 창고를 쓰는 이야기였습니다. 그리고 그 마지막 편에서, 하나의 빚을 남기고 3부를 닫았어요. 그 무렵 Hermes의 브레인은 27B였고, 그 27B가 왜 그렇게 느렸는지는 다음 부에서 풀겠다고 했습니다.
사실 그보다 더 일찍, 12편에서도 같은 질문을 접어둔 적이 있습니다. 모델이 느리다는 것 자체는 확인했는데, 왜 하필 그 모델이 그렇게 느린지는, 모델의 문제라기보다 그것을 올린 기계가 초당 얼마를 읽어낼 수 있느냐의 문제라며 그 자리에서는 접어두었죠.
이제 4부가 시작됐으니 그 빚을 갚습니다. 이 편의 주제는 하드웨어입니다. 창고도, 에이전트도, 도구도 아닌, 그 모든 것이 올라가 있는 박스 하나의 물리적 특성이 왜 모델 선택을 지배했는지에 대한 이야기예요.
결론을 먼저 말하면, 통합메모리 박스에서 토큰 속도는 하나의 공식으로 정리됩니다. 속도는 대역폭을, 활성 파라미터 수와 파라미터당 바이트로 나눈 값입니다. 그리고 이 공식이 이 시리즈의 주력 모델을 세 번이나 갈아치우게 했습니다. 차근차근, 그 공식에 도달한 순서대로 따라가 보겠습니다.
8 토큰
그 무렵의 브레인은 Qwen3.5-27B였습니다. 지금은 27B라고만 부르지만, 당시 기록에는 모델이 초당 8토큰을 만들었다고 남아 있어요. 8토큰이 어느 정도냐면, 사람이 천천히 읽는 속도보다 느린 수준입니다. 질문 하나에 대답을 두세 문장만 써도, 그 생성만으로 수십 초가 지나갑니다.
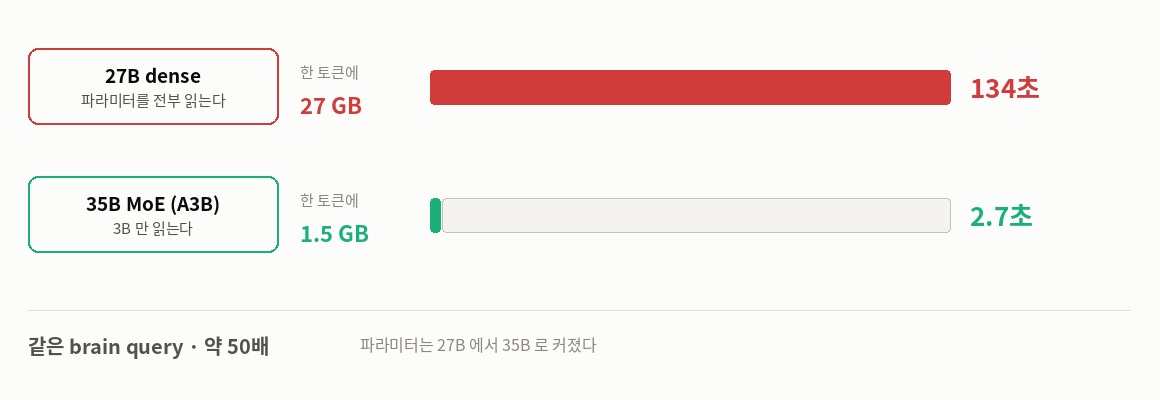
12편에서 썼던 3분 봇의 첫 번째 원인이 바로 이 속도였습니다. 브레인에 뭔가를 물어보면 검색은 순식간인데, 대답을 만드는 단계에서 시간이 통째로 소모됐고, 기록에 남은 수치로는 쿼리 하나가 134초였습니다. 2분이 넘게 입력 표시만 깜빡이고 있는 셈이라, 슬랙에서 물어보는 일 자체가 부담이 될 수밖에 없었죠.
문제는 왜 27B가 그렇게 느린가였습니다. 이 모델은 dense라서, 토큰 하나를 만들 때 270억 개의 파라미터를 전부 읽어야 합니다. 그래픽카드처럼 메모리 대역폭이 넉넉한 기계에서는 이게 그렇게 큰 문제가 아니에요. 그런데 이 박스는 그래픽카드가 아닙니다.
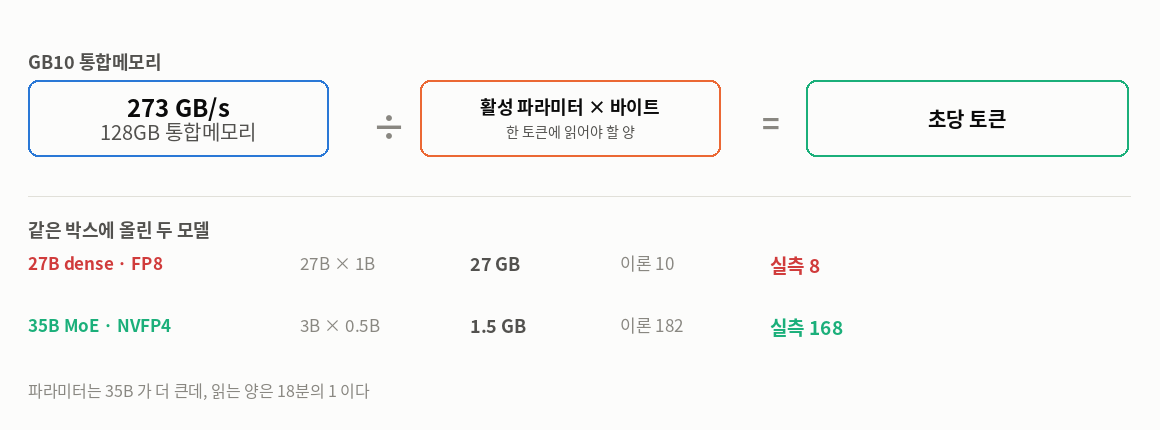
GB10은 CPU와 GPU가 메모리를 하나로 공유하는 통합메모리 구조이고, 그 메모리 대역폭이 사양표에 273GB/s로 적혀 있습니다. 토큰 하나를 만들 때마다 27B의 파라미터를 전부 읽어야 하는데, 파라미터 하나당 1바이트(FP8)라고 치면, 토큰 하나당 27GB를 읽어야 합니다. 273 나누기 27, 이론상 초당 10토큰이 한계예요. 실측 8은 그 한계에 꽤 가까이 붙어 있는 숫자입니다.
즉 이 느림은 모델이 게을러서가 아니라, 기계가 물리적으로 더 빨리 읽을 수 없어서였습니다. 모델을 탓해 봐야 달라질 것이 없었어요.
대역폭을 나눈다
이 공식을 지배하는 물리적 조건이 하나 있습니다. 통합메모리라는 구조예요. 이 박스의 CPU와 GPU는 각자 메모리를 갖는 대신, 128GB짜리 메모리 하나를 같이 씁니다. 덕분에 모델 전체가 메모리에 들어가고, 그래픽카드의 VRAM처럼 따로 신경 쓸 필요가 없습니다.
그런데 그 대가로, GPU는 자기 전용 고대역폭 메모리 대신 CPU용 메모리 버스의 대역폭을 나눠 씁니다. 그래픽카드라면 수 TB/s를 넘나드는 곳이, 이 박스는 273GB/s가 전부예요. 숫자만 보면 커 보이지만, 대형 모델을 굴리기에는 그리 넉넉한 편이 아닙니다.
여기서 속도 공식이 나옵니다. 토큰 하나를 만들려면 그 모델의 파라미터를 전부 읽어야 하니, 초당 토큰 수는 대역폭을 (파라미터 수 × 파라미터당 바이트)로 나눈 값에 가깝습니다. 파라미터가 27B이고 바이트가 1이면 27GB, 초당 10토큰이 한계예요. 파라미터가 100B를 넘고 바이트가 2면 200GB가 넘어, 초당 1토큰대까지 떨어집니다.
이 공식이 말해주는 것은, 모델이 몇 B냐가 아니라 한 토큰에 몇 바이트를 읽어야 하냐가 속도를 정한다는 것입니다. 같은 모델이라도 양자화로 바이트를 줄이면 빨라지고, 아무리 작아도 읽을 것이 많으면 느립니다. 그리고 이 공식은 분모에 있는 두 값 모두를 줄일 수 있게 해주는데, 바이트는 양자화로, 파라미터 수는 다음 절의 구조로 줄입니다.
3B만 읽는다
양자화로 바이트를 반으로 줄이는 것은 반쪽짜리 해법입니다. 파라미터 수를 줄이는 쪽에 더 재미있는 길이 있었는데, 그것이 MoE였습니다. MoE는 거대한 모델 안에 전문가(expert)들을 여럿 넣어 두고, 토큰이 들어올 때마다 라우터가 그중 일부만 골라서 계산하는 구조예요. 전체 파라미터는 크지만, 토큰 하나를 처리할 때 실제로 읽는 것은 일부뿐입니다.
12편에서 3분의 첫 번째 원인으로 지목됐던 그 느림, 그 원인을 갚으러 내가 그 박스에 올린 것이 Qwen3.6-35B-A3B였습니다. 35B라고 이름붙었지만, 활성 파라미터는 3B뿐이었어요. 토큰 하나를 만들 때 읽는 양이 27B dense의 27GB에서, 3B를 4bit(NVFP4)로 읽는 1.5GB로 줄었습니다.
대역폭 공식에 넣으면 이론상 초당 180토큰대이고, 실제로 재니 168토큰이 나왔습니다. 기록상 27B의 8토큰과는 비교가 안 되는 수준이었어요.
이 교체가 체감으로 다가온 것은 속도 표보다 실제 사용에서였습니다. 같은 brain query를 27B로 돌리면 134초였는데, A3B로 바꾸고 나니 2.7초가 됐습니다. 134를 2.7로 나누면 49.6, 약 50배입니다. 파라미터는 오히려 27B에서 35B로 커졌는데, 속도는 50배가 빨라진 것이죠. 3분 걸리던 대답이 눈 깜빡할 사이에 오는 수준이 되니, 슬랙에서 브레인을 쓰는 일이 처음으로 부담 없는 일이 됐습니다.
이 대목이 이 편의 핵심입니다. 큰 모델이 느리고 작은 모델이 빠르다는 상식은, 통합메모리 박스에서는 "많이 읽는 모델이 느리고 조금 읽는 모델이 빠르다"로 바뀝니다. 활성 파라미터가 몇 B냐, 그것이 전부였습니다.
그러나 얇았다
여기까지 읽으면 A3B가 답처럼 보입니다. 그런데 이 시리즈가 거기서 멈추지 않았다는 것이, 이 편에서 가장 말하기 어색한 대목이에요. A3B로 바꾸고 보니, 빨라진 것과 별개로 능력이 얇게 느껴졌습니다. 당시 기록에는 그대로 남아 있습니다. MoE는 활성 파라미터가 적어 빠르지만, 능력이 얇게 느껴진다고요.
토큰 하나를 만들 때는 3B만 읽지만, 그 3B만으로는 dense 27B가 내던 답의 깊이를 따라가지 못했습니다. 13편의 실험에서 본 경계와도 맞닿아 있습니다. 정형 작업은 해내고 판단이 필요한 일은 사람에게 남기던 그 경계요.
느린 모델 위에서는 모든 작업이 길어지고, 길어질수록 프로세스가 죽을 구멍이 늘어납니다. 그리고 능력이 얇으면 일이 끝나긴 끝나도 그 결과물을 믿을 수 없고, 결과물을 믿을 수 없으면 그 일을 다시 사람이 검토해야 하니, 속도를 올린 보람이 반으로 접힙니다. 속도만으로는 이 경계를 옮길 수 없었습니다.
그래서 나는 다시 27B로 돌아갔습니다. 이번에는 NVFP4 양자화에 MTP3라는 여러 토큰 예측을 얹은 버전이었고, 속도는 13에서 15토큰대까지 올라왔습니다. 처음의 8토큰보다는 나았지만, dense가 가진 본질적인 한계는 그대로였어요.
그러던 무렵, 시선은 다른 곳으로 옮겨갔습니다. Qwen3.5-122B-A10B, 총 122B에 활성 10B인 MoE였습니다. 활성 파라미터가 27B의 절반도 안 되니, 이론상 27B dense보다 두 배쯤 빨라야 하고, 실제로 스톡 상태에서 초당 29토큰, 거기에 추측 디코딩을 얹으니 81토큰까지 올라왔습니다. 27B가 초당 8토큰이던 그 박스에서, 122B가 81토큰을 냈다는 것은, 파라미터는 네 배가 넘는데 속도는 열 배가 넘는, 공식이 없으면 설명할 수 없는 숫자였습니다.
이 이야기는 다음 편에서 풀어야겠습니다. 이 편은 공식까지 입니다.
이 시리즈의 4부는 하드웨어와 모델 이야기입니다. 그리고 그 첫 편의 결론은, 창고도 에이전트도 아닌 박스 하나의 대역폭이 모든 선택을 지배했다는 것입니다. 모델을 고를 때 몇 B인지 묻는 것은, 이 박스 위에서는 두 번째 질문입니다. 먼저 물어야 할 것은 한 토큰에 몇 바이트를 읽어야 하냐이고, 그다음이 그 읽을 것이 뭘로 채워져 있냐입니다.

27B를 두 번 버리고, 35B로 갔다가, 122B에 정착한 지난 두 달을 한 문장으로 요약하면 그렇게 됩니다. 모델이 몇 B냐가 아니라, 활성 파라미터가 몇 B냐.