[세컨드브레인 개발기] 3. 20k 문서를 실제로 읽어들이기 — 로더 지옥
[세컨드브레인 개발기] 3. 20k 문서를 실제로 읽어들이기 — 로더 지옥
앞 편에서 문서 2만 개를 만나 설계를 고친 이야기를 썼습니다. 벡터 검색 계층을 얹고, 청크로 쪼개서 임베딩하면 된다고 적었는데, 그 문장에는 앞 단계가 하나 빠져 있습니다.
파일에서 텍스트를 꺼내는 일.
이게 이 프로젝트에서 제일 지루하고, 제일 오래 걸리고, 블로그에서 아무도 안 쓰는 부분입니다. RAG 튜토리얼은 대부분 PyPDFLoader 한 줄로 끝나요. 실제 자료는 그렇게 생기지 않았습니다. 공문 하나만 열어봐도 한글 파일이 나오고, 구형 오피스 파일이 나오고, 스캔 이미지가 나옵니다. 이 글이 그 삽질을 반복하지 않게 해주면 좋겠습니다.
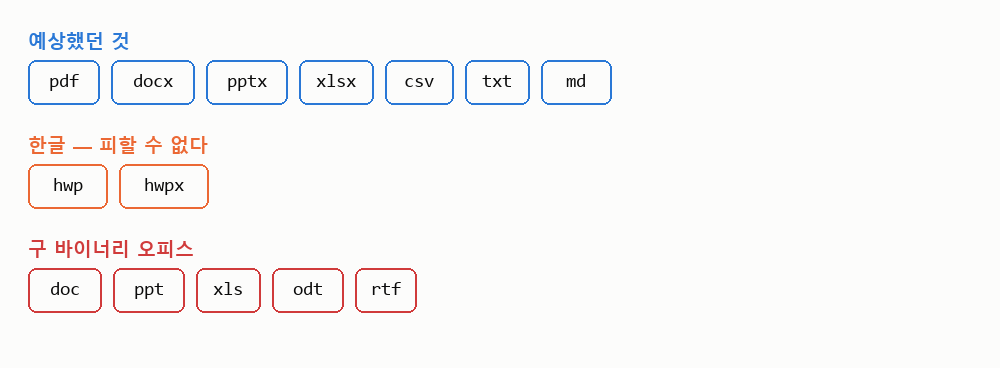
처리해야 했던 포맷
드라이브에서 당겨온 파일의 확장자를 세어보고 정리한 목록입니다.
pdf   docx   pptx   xlsx   csv   txt   md
hwp   hwpx
doc   ppt    xls    odt    rtf
첫 줄은 예상했던 것들이고, 문제는 아래 두 줄입니다. 이 두 줄 때문에 사다리가 생겼다고 봐도 됩니다. 앞 편 끝에서 "상상보다 더 난장판"이라고 했는데, 목록을 보면 그 말이 왜 나왔는지 보입니다.
hwp는 한국 대학 자료에서 피할 수 없는데, 공문, 계획서, 보고서, 심의 서류가 전부 한글 파일이고, 영어권 도구 생태계에는 이 포맷을 위한 성숙한 로더가 없습니다. 영어로 검색해봐야 파이썬 패키지 하나로 끝나는 문제가 아니고, 구할 수 있는 것도 대부분 오래전에 방치된 프로젝트입니다.
구 바이너리 오피스 포맷도 여전히 살아 있는데, 2010년대 초에 만든 발표자료가 .ppt로 남아 있고, 누가 보내준 .doc가 그대로 폴더에 남아 있습니다. 2007년 이후 포맷(docx/pptx/xlsx)과 그 이전 포맷은 파일 구조가 완전히 다른데, 앞은 zip 안의 XML이고, 뒤는 OLE 복합 문서입니다. 같은 "문서"라는 이름인데, 내부는 아무 관련이 없다고 봐도 됩니다.
폴백 사다리로 풀었다
포맷별로 라이브러리를 하나씩 붙이는 대신, 빠른 것부터 시도하고 실패하면 무거운 것으로 내려가는 사다리로 만들었습니다.
| 단계 | 대상 | 방법 |
|---|---|---|
| 1 | pdftotext (poppler) |
|
| 2 | docx · pptx · xlsx · hwpx | 표준 라이브러리 zip + XML 파싱 |
| 3 | hwp | hwp5txt / pyhwp |
| 4 | doc · ppt · xls · odt · rtf | LibreOffice soffice 헤드리스 변환 |
| 5 | 스캔 PDF · 이미지 | pdftoppm → tesseract OCR (kor+eng) |

몇 가지 짚어둘 게 있습니다. 2단계에 라이브러리를 안 쓴 건 의도적인데, docx·pptx·xlsx·hwpx는 전부 zip 컨테이너 안에 XML이 들어 있는 구조라서, 텍스트만 필요하다면 표준 라이브러리의 zipfile로 열고 텍스트 노드를 긁는 것으로 충분합니다. XML은 사람이 읽기 불편할 뿐, 텍스트를 빼내기에는 충분히 단순해요. 서식이나 표 구조를 살릴 거면 전용 라이브러리가 필요하겠지만, 임베딩에 넣을 텍스트에는 과합니다. 의존성이 하나 줄면 3년 뒤에 안 깨질 확률이 올라갑니다.
4단계 LibreOffice는 최후의 수단인데, soffice 헤드리스 변환은 파일 하나당 프로세스를 새로 띄우고, 느리고, 간혹 멈춥니다. 그래도 구 포맷을 이걸로 넘기는 쪽이 포맷별 파서를 여섯 개 붙이는 것보다 유지보수가 쉽다고 생각합니다. 다만 이 경로로 가는 파일 비율이 높아지면 전체 색인 시간이 급격히 나빠지니, 로그를 남겨서 지켜봐야 합니다.
5단계 OCR은 껐다 켤 수 있게 뒀는데, 스캔 PDF를 tesseract로 통째로 뜨면 페이지당 수 초가 나가서, 첨부파일 이미지나 스캔 문서에만 걸었습니다. 한국어 자료라 kor+eng를 같이 줘야 하는데, kor만 주면 문서 안의 영어 용어가 망가집니다. 사다리의 전제는, 위에서 성공하면 아래를 안 본다는 것이니, 위 단계일수록 조용히 틀리면 안 됩니다.
수집 — 서버가 드라이브를 직접 당긴다
원래 구조는 맥이 클라우드에서 받아 서버로 밀어주는 것이었는데, 2만 개 53GiB를 앞두고 그 경로를 버렸습니다. 맥이 병목이고, 노트북을 닫으면 멈추고, 같은 데이터가 두 번 복사됩니다. 셋 다 감당할 수 없는 이유였어요.
그래서 서버에 rclone(당시 v1.74.2)을 깔고 드라이브를 직접 당기게 했는데, 여기서 정한 것 세 가지가 나중에 다 쓸모가 있었습니다. 지금 돌아보면 운 좋게 고른 것 같아요.
자체 OAuth 클라이언트를 만들었고, 스코프를 readonly로 잡았습니다. rclone 공용 클라이언트를 쓰면 다른 사용자와 API 쿼터를 공유해서 대량 전송에서 막히고, readonly로 잡으면 스크립트 사고로 원본이 지워질 경로가 아예 없습니다. 자동화가 남의 클라우드를 만지는 상황에서는 이게 싸고 확실한 안전장치입니다. 비용도 들지 않으면서, 이 정도 안전장치를 얻는 일은 드물어요.
확장자 화이트리스트도 걸었습니다. --include로 문서 확장자만 받았는데, 드라이브에는 동영상과 데이터셋이 섞여 있고, 그건 브레인에 넣을 것도 아니면서 용량은 큽니다. 받을 것을 고르는 게 아니라 받지 않을 것을 나중에 지우는 구조가 되면, 전송 시간과 디스크를 이중으로 낭비합니다.
구글 문서 네이티브 파일은 다운로드가 아니라 변환입니다. Google Docs/Sheets/Slides는 바이너리 파일이 아니라 서버 측 객체라서 그냥 가져올 수 없고, --drive-export-formats docx,xlsx,pptx,pdf를 줘서 어떤 포맷으로 변환해 받을지 지정해야 합니다. 이걸 모르면 파일 목록에는 보이는데 받아지지 않는 문서가 대량으로 남고, 로그에는 딱히 에러도 안 남습니다.
곁가지 함정 두 개
로더와 직접 상관없지만 같은 시기에 밟았고, 둘 다 조용히 틀린 결과를 만드는 종류라, 꼭 적어두고 싶습니다.
로컬 LLM의 추론 태그부터. 당시 쓰던 Nemotron은 사고 과정을 분석 태그로 감싸고 답을 내는데, 응답에서 답만 꺼내려면 그 뒤를 잘라야 합니다. 처음에는 단순하게 첫 분석 뒤를 잘랐는데, 그 문자열이 본문에도 나올 수 있습니다. 마지막 분석을 기준으로 잘라야 합니다. 첫 번째 것으로 자르면 추론 산문이 위키 페이지에 그대로 실립니다. 태그 하나 때문에, 위키 전체가 오염될 뻔했습니다.
맥의 기본 도구 버전도 함정이었습니다. macOS 기본 bash는 아직 3.2이고, rsync는 2.6.9인데, --info= 같은 옵션이 없고, 빈 배열과 set -u 조합에서 최신 bash와 다르게 죽습니다. 맥에서 돌리는 동기화 스크립트는 이 두 개를 전제로 써야 하고, 로컬에서 brew로 깐 최신 bash로 테스트하고 launchd에 걸면 그때부터 조용히 안 됩니다. 로더 문제가 아니라 환경 문제인데, 증상은 똑같이 조용합니다.
여기까지가 함정 둘이고, 하나 더는 함정이라기보다 판단인데 같이 적어둡니다. 짧은 노트는 위키에서 제외했습니다. 120자 미만 노트는 LLM 합성 대상에서 빼고 검색 색인에만 넣었는데, 한 줄 메모를 70초 들여 위키 페이지로 만들 이유가 없습니다. 비용이 문서 개수에 정비례하는 구조에서는 이런 필터 하나가 그대로 시간으로 돌아옵니다. 로더만 완성하면 끝나는 줄 알았는데, 주변부가 이렇게나 붙어 있었습니다.
실패한 부분
여기까지가 잘된 이야기고, 안 된 이야기도 써야 정직합니다.
드라이브 증분 자동 수집은 결국 제대로 안 굴러갔는데, 초기 적재는 성공했고, 새벽 3시 동기화 크론까지 걸었고, 그때까지는 완벽하게 돌아가는 것처럼 보였습니다. 두 달 뒤 시스템 전수 점검을 하면서 확인한 상태가 이랬습니다.
드라이브 소스 폴더    없음
동기화 크론          없음
동기화 스크립트       .sh (리눅스 전용, 이관한 윈도우 호스트에서 실행 불가)
OAuth 토큰           만료 이력 있음
호스트를 리눅스 박스에서 윈도우 머신으로 이관하면서, 셸 스크립트로 된 수집 경로가 통째로 죽었습니다. 문제는 언제 죽었는지 내가 모른다는 점입니다. 전수 점검을 하기로 마음먹은 날 처음 확인했고, 그 사이에 알려준 것은 아무것도 없었습니다. 자동화가 죽었는데 아무도 모르는 것, 이게 자동화의 가장 흔한 죽음입니다.
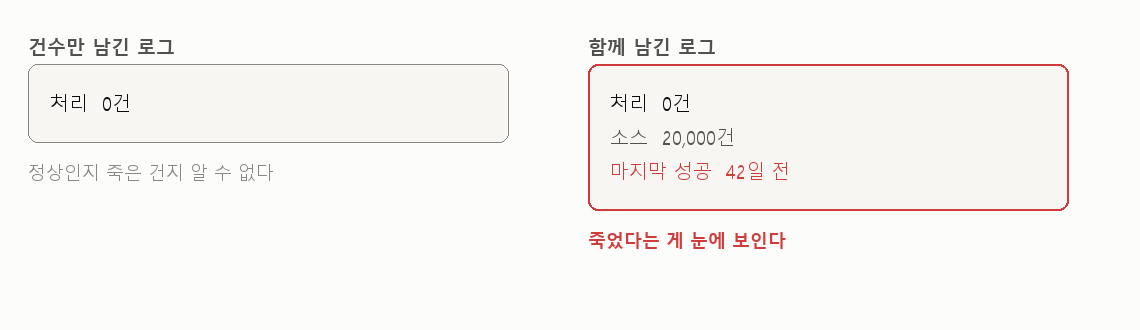
이게 이 시리즈에서 반복해서 나오는 모양입니다. 수집 파이프라인은 에러를 내며 죽지 않고, 처리 건수가 0이 되면서 죽습니다. 그런데 0은 "새 문서가 없다"와 구분되지 않고, 평소에도 0이 정상인 날이 있으니, 로그를 봐도 이상하지 않습니다.
교훈으로 정리하면 이렇습니다. 수집 파이프라인에 처리 건수만 남기면 안 되고, 마지막 성공 시각과 소스 측 총 개수를 같이 남겨야 합니다. 그러면 "0개 처리" 옆에 "소스에 20,000개 있음 / 마지막 성공 42일 전"이 찍혀서, 이상함이 눈에 보입니다. 숫자 두 개가 나란히 찍히면, 죽음은 조용히 있을 수 없습니다. 지금은 이런 항목을 매일 아침 점검 규칙으로 박아뒀는데, 그 이야기는 5부에서 합니다.
다음 편에서는 그렇게 읽어들여 만든 위키를 열어봤더니 일부가 영어로 쓰여 있던 이야기를 해 보겠습니다. 프롬프트를 고친 뒤에도 이미 만들어진 페이지는 그대로였다는, 더 일반적인 문제로 이어집니다.