유휴 2080 두 장에 뭘 넣을까 — 64K로 줄이니 1.5배 빨라졌습니다
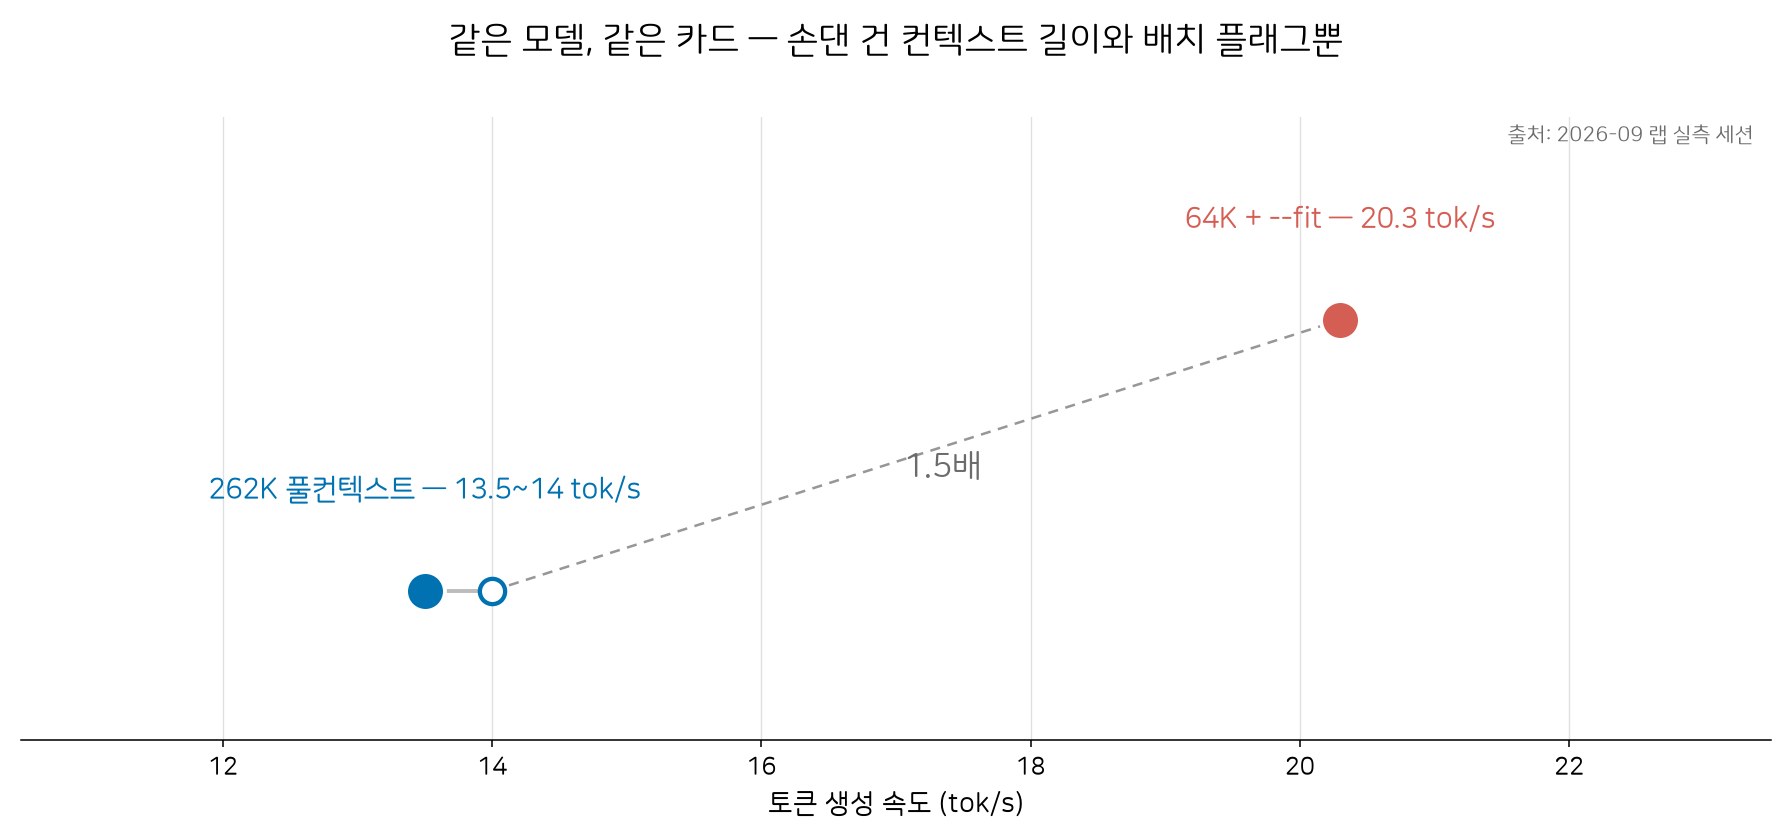
선풍기만 돌던 구형 데스크톱 하나를 가지고 있었는데, 그 안에 VRAM 8GB짜리 카드가 두 장 꽂혀 있었습니다. 하는 일 없이 놀고 있었으니 버리자니 아깝고 굴려보자니 걱정되는 상태였죠. 먼저 숫자부터 말씀드립니다. Qwen 35B-A3B를 262K 풀컨텍스트로 올려보니 생성 속도가 13.5~14 tok/s였습니다. 손댄 것은 컨텍스트를 64K로 줄이고 배치를 정하는 플래그 두 개뿐이었어요. 모델을 바꾼 적도, 하드웨어를 산 적도 없는데 속도는 1.5배가 났습니다.
놀고 있던 카드 두 장
대상 머신은 윈도우 워크스테이션 한 대입니다. 튜링(Turing) 세대의 RTX 2080 Super를 두 장 꽂아두고 RAM은 32GB인 기계로, 몇 년째 별다른 작업 없이 부팅만 되던 상태였어요. 계획은 이 두 장에 Qwen 35B-A3B MoE를 올려 OpenAI 호환 API 서버로 쓰는 것이었습니다. 웨이트는 22.1GB짜리 GGUF 파일이고, 비전용으로 899MB짜리 mmproj 파일이 하나 더 붙습니다. 숫자만 보면 합산 16GB인 카드 두 장에 22.1GB가 안 들어가요. 트렁크보다 큰 여행가방을 싣겠다는 셈이죠.
그래도 시도가 되는 이유는 MoE 구조에 있습니다. 35B라는 이름값과 달리 토큰 하나당 실제로 깨어있는 파라미터는 3B뿐이에요. 전문가들이 사무실에 빽빽이 출근해 있는데, 전화 한 통에는 그중 세 명만 응답하는 형태라고 보시면 됩니다. 자리에 앉은 사람만 일하니 토큰당 계산은 무겁지 않은데, 어느 전문가가 다음에 호출될지는 미리 알 수 없어서 웨이트 전체는 최소한 RAM에 상주해야 해요. 책상(GPU)이 좁으면 책장(RAM)을 책상 옆에 붙여놓는 구조인 셈입니다.
방법을 두 번 거절당했습니다
첫 번째 거절은 프레임워크에서 왔습니다. 다른 곳에서 쓰던 FreeToken을 붙여보려 했는데, 튜링 아키텍처를 공식 지원하지 않아요. 최소 조건이 암페어 세대, 즉 RTX 30 이상이라고 적혀 있고, 듀얼 GPU 분할 처리도 지원 대상이 아니었습니다. 미지원을 억지로 설득할 방법은 없어서, llama.cpp 네이티브 Windows 빌드로 노선을 바꿨습니다.
그런데 우회로도 벽이었습니다. WSL2에는 메모리 기본 제한이 걸려 있어서, 15GB까지만 열렸어요. Host RAM이 32GB인데 MoE 오프로드에 그 전부를 쓸 수가 없었고, 계약서상 15인실 방에 32명이 눌러앉는 격이었습니다. WSL2를 아예 우회해서 네이티브 Windows 빌드로 가니, 그때야 RAM 전체가 판으로 올라왔습니다.
경비원과 퇴근 안 한 손님
빌드를 끝내고 나서 등장한 다음 상대는 Windows Smart App Control이었습니다. 서명되지 않은 llama.cpp DLL을 차단하고 프로세스를 즉시 종료시켰는데, 오류 코드로는 0xC0E90002가 떨어졌어요. 예약 목록에 없는 방문객은 아예 들여보내지 않는 경비원이라, 누가 뭐라고 설명해도 문은 안 열립니다. 결국 관리자 권한으로 SAC를 끄고 재부팅해서 통과했는데, 보안 경비원을 집으로 돌려보낸 게 내심 좀 찜찜했습니다.
다음 벽은 컨텍스트 한도였습니다. 더 올라가야 할 로드에서 자꾸 128K 지점에 막혔는데, 정체는 이전에 죽은 프로세스의 잔재와 데스크톱 자체가 점유한 VRAM(dwm과 System)이었어요. 손님은 이미 퇴근했는데 키카드 반납이 안 돼서, 방이 지금도 사용 중으로 뜨는 상태였던 거죠. 죽은 프로세스 잔재를 정리하고 나서야, 262K 풀컨텍스트 로드가 통과됐습니다.
전문가를 책장으로, 계층을 책상으로
배치의 핵심은 전문가 계층을 RAM에 명시로 재우는 것입니다. --n-cpu-moe로 40개 계층을 CPU RAM에 배치하고, --load-mode none과 --fit on으로 나머지 계층을 카드 두 장에 최적 배치했어요. --fit은 값을 꼭 지정해야 하고(--fit on), 강제 풀오프로드인 -ngl 99와 병용하면 충돌합니다.
--n-cpu-moe 40    전문가 40개 계층을 RAM에 명시 배치
--load-mode none
--fit on          값 지정 필수, -ngl 99와 병용 시 충돌
KV cache q8_0 · flash attention on
이렇게 262K 풀컨텍스트가 올라갔고, 속도는 13.5~14 tok/s가 나왔습니다. 활성 3B치고는 느리다고 느껴지는데, 막힌 지점은 대역폭이었어요. 실측으로 약 42GB/s가 천장이었고, 전문가는 위층에서 대기 중인데 작은 엘리베이터 하나가 전부인 건물 같은 상태였습니다. 문제는 '올라가느냐'에서 '어디에 두면 빨라지느냐'로 성격이 바뀌어 있었죠.
그래서 반대 방향으로 손봤습니다. 컨텍스트를 262K에서 64K로 줄이고, --fit으로 GPU에 얹을 수 있는 계층을 그만큼 더 올려봤어요. 나온 속도는 20.3 tok/s였고, 결과적으로 1.5배입니다. 모델을 바꾸지도 않았고 하드웨어를 사지도 않았는데, 손댄 것은 컨텍스트 길이와 배치 플래그뿐이었습니다.
서비스는 이 상태로 굳혔습니다. 재부팅 뒤에도 자동으로 띄우도록 스케줄드태스크에 등록해뒀고, 다른 머신에서 돌던 챗 서버의 엔드포인트를 이쪽으로 배선 전환했어요. 선풍기만 돌던 기계가 초당 20토큰을 넘기는 API로 바뀌었습니다.
한계와 다음
오래된 GPU의 가치는 FLOPS가 아니라, '얼마나 큰 모델을 문맥째 올릴 수 있나'에 있었다는 것을 이번에야 처음 확인합니다. 배움은 여기까지가 틀이고, 실제 상황은 속도와 문맥 길이가 같은 자원을 먹고 싸우는 트레이드오프였어요. 64K부터 262K까지 구간별 세부 곡선은 아직 안 재봤습니다.
262K를 포기하고 20.3을 택한 교환이 옳은지는, 판단을 유보합니다. 긴 문맥을 쓰는 워크로드가 실제로 있을지가 아직 미결이라서요. SAC은 보안 장치를 끈 상태라 윈도우 환경에서 부담이 남고, 공식 미지원 카드의 배합을 수동으로 굴리는 터라 llama.cpp 빌드나 버전이 바뀌면 이 구성을 전부 다시 검증해야 합니다.
빨라진 것은 1.5배라는 속도계 숫자였고, 이 교환이 득인지 손인지는 아직 장부에 못 적었어요. 다음에 이 문장을 채워 넣을 것은 속도가 아니라 워크로드일 겁니다.