수업 챗봇 QA를 자동으로 증식시켰는데 아무것도 안 늘었습니다
오전 7시의 약속 — 위키가 스스로 자라기로 했습니다
우리 연구실에는 학생의 질문을 수업 위키에서 검색해서 답해주는 챗봇이 있습니다. 흠은 처음부터 뻔했습니다. 위키에 없는 것을 물리면 조용해진다는 점이지요. 답을 모르니 모른다고 할 수밖에 없는데, 그걸 그냥 둘 수가 없어서 위키가 스스로 먹이를 먹이는 파이프라인을 만들었습니다. 매일 아침 7시, 제가 출근하기 전에 어제의 채팅 로그를 소화시키는 크론 잡입니다. 약속은 한 줄입니다. 한 번 나온 질문은 위키에 남아서, 다음에 같은 걸 물은 학생은 바로 답을 받는다는 것이지요.
흐름은 이렇습니다. 학생 질문을 모아서 수업 자료 관련인 것만 고른 뒤, 위키에서 검색을 걸어 봅니다. 점수가 충분히 높게 나오면 그 페이지의 '자주 묻는 질문' 절로 승격시키고, 기준을 넘지 못하면 자료 공백 백로그로 옮겨 담습니다. 백로그는 제가 검토할 때까지 묵어 두는 사물함 같은 곳입니다.
가드레일도 하나 걸어 뒀습니다. 질문만 가지고 새 위키 페이지를 만드는 것은 허용하지 않는 규칙이지요. 질문이 들어올 때마다 봇이 강의 페이지를 스스로 키우면 위키가 금방 지저분해지니까요. 그래서 승격 문은 기존 페이지의 FAQ 절을 보강하는 길 하나만 열어 뒀습니다. 페이지 수가 0개인 건 설계대로일 수 있지만, FAQ 절은 어딘가에서 늘어야 하는 것이 자기증식의 요지였습니다.
처리 19건이라고 보고한 스크립트, 결과는 0
진단은 9월 7일 아침에 나왔습니다. 일상 보고인데 눈길을 끄는 문장이 붙어 있었지요. 지금까지 처리한 세션은 19건인데, '자주 묻는 질문' 절이 생긴 페이지는 0개라는 내용이었습니다.
| 항목 | 실측치 (9/7 시점) |
|---|---|
| 처리한 대화 세션 | 19건 |
| 위키 FAQ로 승격된 페이지 | 0개 |
| 공백 백로그에 쌓인 질문 | 9건 |
| 그중 같은 질문의 근사 중복 | 3건 |
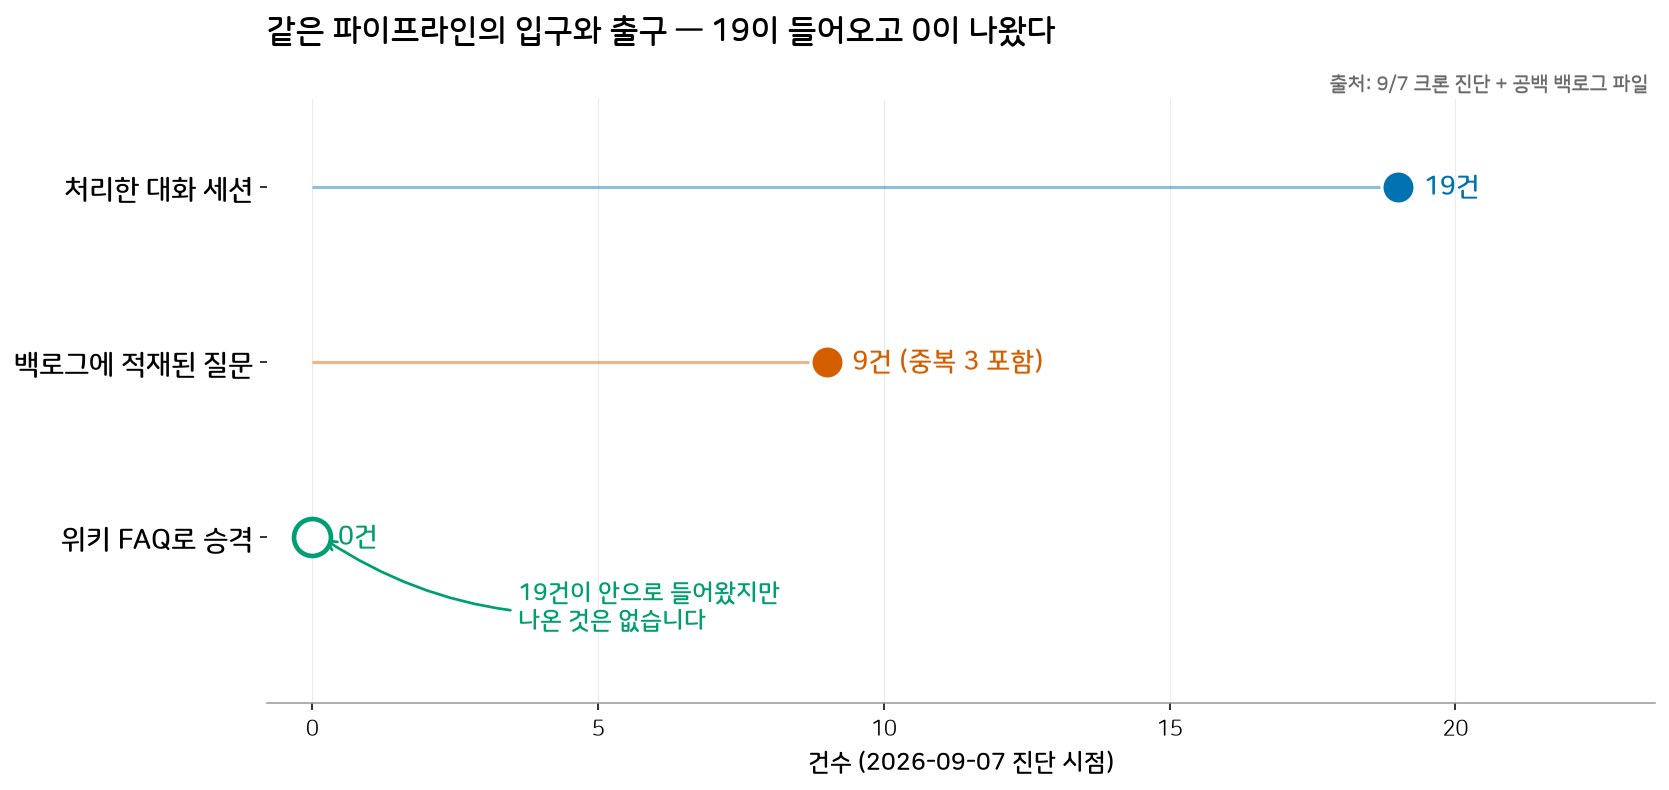
8월 마지막 주부터 9월 첫째 주까지의 보고를 거꾸로 더듬어 봤습니다. 질문이 없었던 게 아니었어요. 질문은 계속 들어오고 있었습니다. CPU와 GPU의 구조적 차이를 묻는 질문, 아두이노를 USB 케이블에 연결하는 방법을 묻는 질문, 글로벌 ISP가 정확히 무엇을 하는 곳인지 묻는 질문까지요. 하나같이 우리 위키가 아직 답하지 못한 것들이었는데, 그중 위키에 들어간 것은 한 개도 없었습니다. 파이프라인은 열흘 넘게 질문을 채팅 로그에서 백로그로 나르는 것만 반복하고 있었습니다. 끝이 없는 컨베이어 벨트였던 셈이지요. 여기서는 분명히 해 두고 싶은 것이, 스크립트가 고장 난 것은 아니었습니다. 규칙대로 움직였고, 보고도 정직해서 19와 0을 숨기지 않았습니다.
범인 하나 — 아무도 못 넘은 0.55라는 숫자
승격의 조건은 검색 점수 0.55 이상이었습니다. 열아홉 개의 질문은 전부 0.55를 넘지 못했습니다. 하나둘이면 질문 탓을 하겠는데 전부라면 임계값 탓을 해야죠. 키 190센티미터가 넘어야 버스에 태우겠다고 해 놓고는 문 앞에서 줄을 선 사람들 전원을 돌려보낸 것과 같습니다.
왜 이렇게 됐는지는 조금 생각해보니 이해가 됐습니다. 당시에는 이 숫자를 굳이 높이 걸어 놓을 이유도, 그대로 둘 이유도 없었습니다. 더 아쉬운 것은 하루 보고에 '결과가 몇 개 나왔는지'를 보여주는 칸이 아예 없었다는 점이지요. 정상 종료라고만 적히니 결과를 열어 볼 생각을 못 했습니다. 강의 위키에는 교수님 문서체의 서술이 길게 들어 있고, 학생 질문은 구어체 한 줄입니다. 프로세스와 스레드의 차이를 묻는 한 줄과, 스케줄링을 설명하는 지문은 뜻은 같은 부류인데 문장을 맞비교해 점수를 만들면 영 닮지 않았거든요. 0.55라는 숫자는 실험으로 뽑은 값이 아니라 그때그때 정해 넣은 자리표시자였습니다. 그 자리표시자가 열흘 동안 생산라인을 조용히 굴리고 있었던 셈입니다.
범인 둘 — 글자가 같아야만 같은 질문으로 인정하는 중복 검사
백로그 파일을 열어 보고 더 기가 막혔습니다. 공백 사물함의 6행, 8행, 12행에 거의 같은 질문이 셋 나란히 놓여 있었지요. 6행은 '운영체제에서 프로세스와 스레드의 개념적 차이와 관리 방식은 무엇인가요'라고 물었습니다. 8행은 '운영체제에서 프로세스와 스레드의 차이점은 무엇인가', 12행은 '운영체제에서 프로세스와 스레드의 차이는 무엇인가'였습니다. 사람이 읽으면 명백히 하나의 질문인데, 중복 제거 로직은 문자열이 똑같아야만 같은 질문으로 쳤습니다. 한 글자만 달라도 남의 것으로 취급하니, 학생들이 같은 걸 세 번 묻는 동안 사물함에는 세 칸이 비어 갔습니다.
이건 멍청해 보이지만 절반은 더 아쉬운 일입니다. 같은 질문이 세 번 들어왔다니, 그만큼 이 수업 자료가 정말로 부족하다는 뜻이거든요. 좋은 신호가 중복 제거 실패에 밀려서 약한 신호 세 개로 희석된 것입니다. 사실 '열아홉 개 중 하나도 승격 못 했다'는 두루마리보다, '같은 질문이 세 번 왔다'는 쪽이 어디를 보강할지 파이프라인이 직접 짚어 준 신호였습니다. 그걸 못 써먹고 있었지요.
멈춘 손과 다음 계획
이 글을 쓰는 지금도 승격 실적은 0입니다. 진단은 9월 7일에 끝났고, 수술은 아직입니다. 아까 짚은 대로 검색 점수가 왜 줄줄이 떨어지는지 로직부터 들여다봐야 합니다. 임계값 탓인지 매칭 방식 탓인지는 아직 구분하지 못한 상태입니다. 그다음엔 정규화로 근사 중복을 병합하는 기능을 넣어 보기, 그리고 쌓인 아홉 건을 제가 직접 검토해서 수업 자료에 먼저 반영해 보기로 해 뒀습니다. 임계값을 낮추면 답변 품질이 얼마나 무너지는지는 아직 검증하지 못했습니다. 고치면 될 것 같다는 말은 쉽지만, 안 해 본 걸 썼다가는 다음 글에서 정정공고를 올려야 할지도 모르니까요.
더 부끄러운 고백을 하나 더 하겠습니다. 오늘 이 글을 준비하며 백로그 파일을 다시 열어 봤는데, 마지막 수정 시각이 9월 4일이었습니다. 그 뒤로 파일은 한 줄도 더 써지지 않은 채 묵어 있었지요. 질문 자체가 마른 것인지, 아직 같은 문턱에서 삼켜지고 있는지 저는 아직 확인하지 않았습니다. 확인해야 할 목록에 이 항목도 추가해 둡니다.
그래도 하나를 배웠습니다. 자동화가 헛돌 때 로그는 아주 멀쩡해 보입니다. 정상 종료라고 하고, 처리량을 성실히 보고하니까요. 그 뒤로 아침 보고에서 처리량 대신 산출물 개수만 봅니다. 몇 개를 했느니보다 몇 개가 나왔느냐가 먼저라는 뜻입니다. 19가 들어가서 0이 나온 이 컨베이어를 이번 학기 안에는 승격 3개짜리로 바꿔 놓을 수 있을지, 다음 글에서는 그 이야기를 쓰게 되기를 바랍니다.