87쪽 연구보고서를 기계에 검토시켰더니 27군데가 나왔습니다
정부 R&D 과제의 1단계 단계보고서를 제출하기 직전에, 마지막 점검을 기계에게 시켰습니다. 과제는 영상 품질을 평가하는 AI를 개발하는 것이고, 수정본을 PDF로 렌더하면 87쪽, 파일로 14.6MB쯤 되는 문서입니다. 이미 다른 심사자의 1차 검토를 받아서 그 지적은 전부 반영한 상태였기에 마음은 반쯤 편했습니다. 반쯤이라고 쓴 데는 이유가 있습니다.
여기서 사람의 고질적인 문제가 나옵니다. 자기가 쓴 글을 눈으로 읽으면 뇌가 자동으로 고쳐서 봅니다. 방금 고쳐놓은 자리는 고쳤다는 기억이 먼저 와서 틀린 게 안 보입니다. 워드프로세서로 쓴 자기 원고를 교정하면 오타가 안 보이는 것과 같은 이치라, 마지막 점검은 원고에 기억이 없는 존재에게 넘기는 편이 정직합니다.
검토에게 넘긴 다섯 가지
기계에게 문서를 검토시킬 때 성패는 무엇을 넘기느냐에 달려 있습니다. 완성된 PDF 하나만 보여주면 검토자는 표면만 읽게 됩니다. 그래서 입력을 다섯 역할로 꾸렸습니다. 90쪽 분권 마커가 들어간 원본 전문 텍스트, 원문과 수정 문단을 나란히 놓고 수정·추가·삭제를 표기한 변경 대조본, 87쪽 A4의 수정본 PDF 그 자체, 이번에 새로 넣은 그림 폴더, 마지막으로 수치들이 맞아야 할 단일 기준 파일인 사실기준.md 입니다.
이건 심사자에게 지난 원고와 고친 자리를 나란히 보여 주면서 기준표까지 함께 쥐여 주는 셈입니다. "좀 봐주세요"로는 부탁이 안 되니까요. 지시문에는 출력 형식도 적어 넣었습니다. 최대 30건, 표 형식, 중요도 순서로 정렬하고, 확신이 없으면 단정하지 말고 '확인 필요'를 붙이라는 것입니다. 파일은 읽기만 하고 고치지 말라는 조건도 걸었습니다.
여기에 '이미 결정된 사항' 제외 목록을 따로 붙였습니다. 다시 지적 금지라고 못 박지 않으면 검토자는 이미 끝난 결정을 자꾸 다시 건드리거든요. 이건 사람 심사자에게도 마찬가지인데, 기계는 이의를 달지 않아서 오히려 편했습니다.
같은 시험지를 채점자 둘에게 나란히
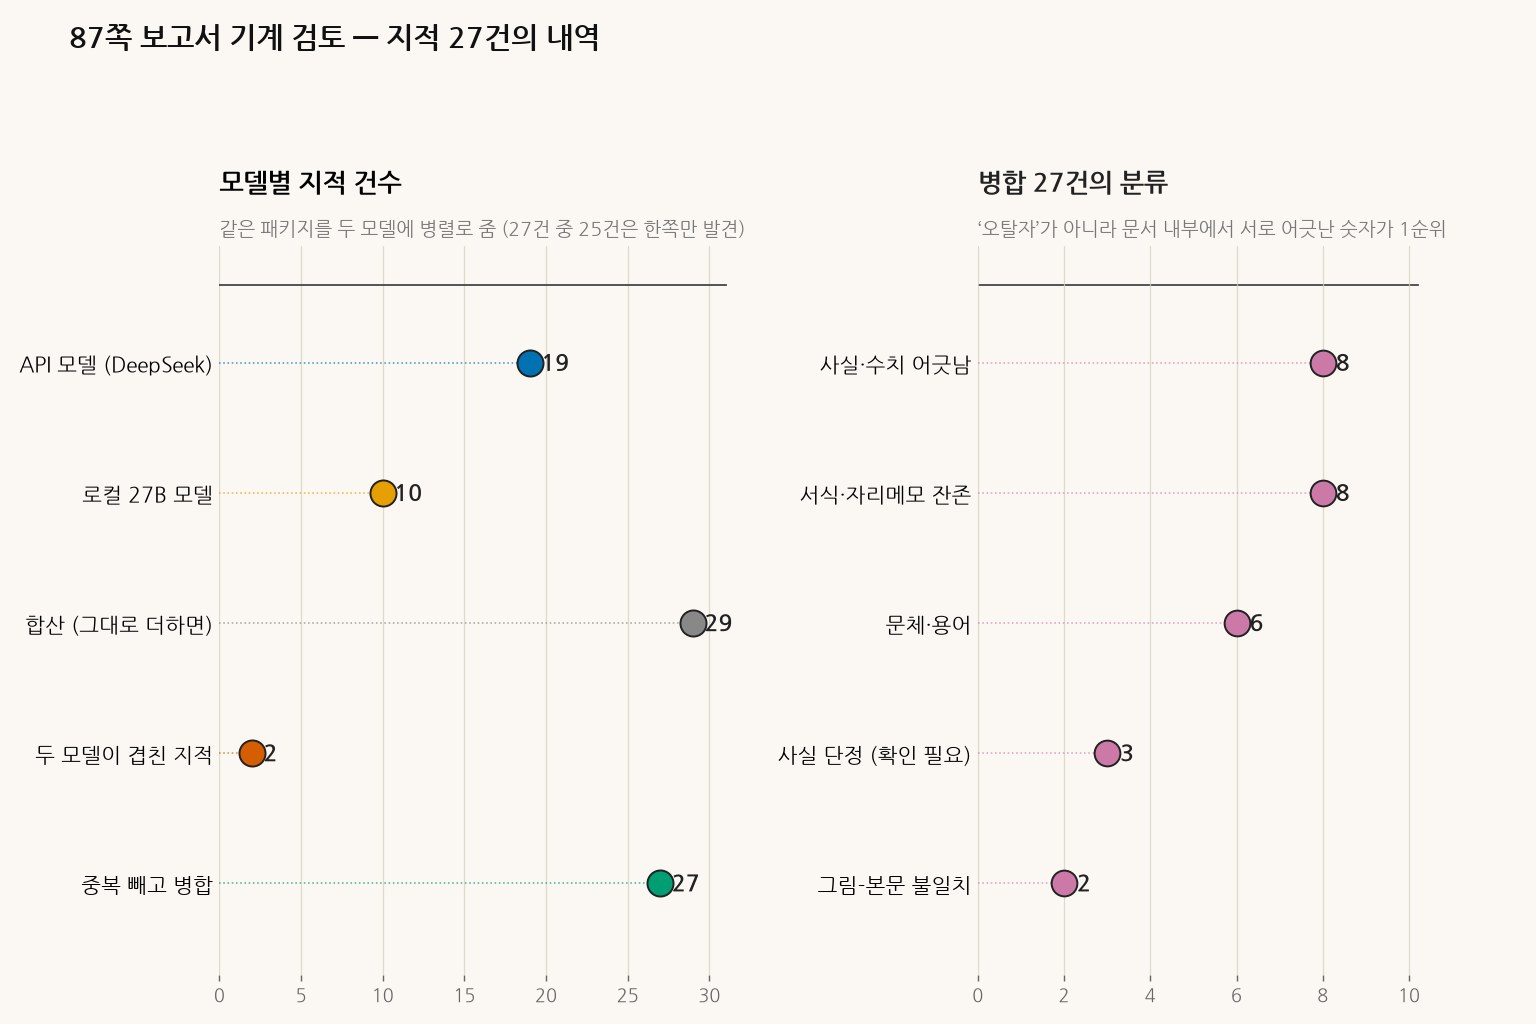
같은 패키지를 두 곳에 동시에 투입했습니다. 로컬에 서빙한 Qwen3.8-27B와 API로 부르는 모델 쪽입니다. 두 검토는 10월 31일 밤 같은 시각에 출발했습니다. 로컬 모델은 약 23분을 들여 10건을 꺼냈고, API 쪽은 6분 남짓 만에 19건을 가져왔습니다.
재미있는 건 여기서부터입니다. 합산 29건인데 두 모델이 같이 찍은 것은 2건뿐이었습니다. 78쪽 자리메모와 71쪽 괄호 서식이 그 중복이고, 겹치는 것을 덜어내면 최종 27건이 됩니다. 27건 중 25건은 둘 중 하나만 본 것입니다. 같은 시험지를 조교 둘에게 번갈아 채점시키면 하나는 모든 문제를 느리지만 꼼꼼히 보고 하나는 빠르게 넘기면서도 붉은 펜 자리는 거의 겹치지 않는데, 그 모습이 그대로 나왔습니다. 페이지를 넘나드는 숫자 대조나 템플릿 잔존 같은 작업은 빠른 사람보다 느린 기계가 훨씬 강하다는 뜻이기도 합니다.
27건을 갈라놓으니
병합 결과를 분류대로 놓으면 아래와 같습니다.
| 유형 | 건수 |
|---|---|
| 사실·수치 불일치 | 8 |
| 서식·자리표시자 잔존 | 8 |
| 문체·용어 | 6 |
| 사실 단정 (확인 필요) | 3 |
| 그림-본문 불일치 | 2 |
집계의 교훈은 오탈자가 최고 업무가 아니라는 쪽입니다. 건진 27건 중 열여섯 건은 숫자 어긋남이랑 형식 잔재인 셈입니다. 외운 전화번호가 명함에 적힌 번호랑 같은지 하나씩 대조하는 일 같은 건데, 사람이 한 번 하면 반드시 놓치고 기계는 서른 번을 해도 질리지 않습니다.
건진 것 중 눈에 띈 세 가지
같은 값으로 적혀야 할 판정 일치도 수치가 어긋난 사례가 있었습니다. 42쪽과 69쪽에서 0.6%p씩 다르게 적혀 있었던 겁니다. 다른 테이블의 재산출 기준 값을 본문이 인용하는 문맥이 섞인 것이 원인이었고, 이 건은 로컬 모델이 잡아 냈습니다. 문서 안에서 이미 계산된 값이라 해도 어느 표의 값을 어디에 썼는지는 사람도 헷갈리는 자리입니다.
두 번째는 더 난감했습니다. 본문에는 약 1,500개로 쓰여 있는데 정확한 집계와 16개 차이가 납니다. 총 개수계 숫자는 문서 안에 43개 차이로 두 값이 병존 중이고, 양쪽 다 내부 합은 각각 맞아 떨어집니다. 원자료 없이 어느 쪽이 정본인지 판별이 안 되니, 기계는 어긋난다는 사실까지만 잡아 주고 무엇을 정본으로 할지는 결국 제 몫이었습니다.
세 번째가 가장 부끄러운 것입니다. 78쪽 서버 예산은 "○○천원" 자리메모가 그대로 살아 있었고, 56쪽 성능지표 표는 "YYYY~YYYY" 템플릿 상태였습니다. 사람이 빨리 고칠수록 이런 자리가 최종 교정 뒤에 남습니다. 남에게 보여 줄 견적서에 '날짜 나중에 기입'이라고 써 두고 보내는 것과 같습니다.
맞았던 것과 못 맞았던 것
기계 검토는 오탐도 스스로 걸러 냈습니다. 대조본에서는 어떤 문단이 잘려 보였는데, 수정본 PDF 원문을 다시 확인해서 완결로 판정하고 자기 지적을 배제한 것입니다. 확인 필요를 붙이라는 지시 하나 덕에 검토자가 원문까지 되돌아본 셈이라, 출력 스펙을 꼼꼼히 적어 두는 게 이렇게 돌아옵니다.
이번 수정으로 새로 쓴 성능 서술과 그림 수치는 사실기준.md 대조에서 전부 일치로 확인됐습니다. 기계가 내린 최종 판단은 제출 전 필수 수정이 최소 3건이라는 것이었습니다. 자리메모와 43개 차이의 정본 확정, 그리고 표기 충돌 표현이 그 세 건입니다.
한계도 정직하게 적어 둡니다. 성능 수치의 절대값은 아직 발표되지 않은 데이터라 이 글에는 싣지 않았습니다. 차이와 개수, 구조만 이야기했습니다. '확인 필요'가 붙은 항목은 결국 저자의 눈으로 결론이 났고, 기계는 문서의 '의미'까지 옹호해 주지는 않습니다. 1차에서 사람이 이미 잡아 준 것들은 이 27건에 들어 있지 않으니, 이건 대체가 아니라 보충 한 겹을 더 얹은 셈입니다.
결국 제출 직전에 고친 자리메모와 숫자 어긋남은 제가 제 눈으로 봤으면 그대로 지나갔을 것들입니다. 기계가 일하는 20여 분 동안 제가 한 일은 기다리는 것뿐이었으니, 드는 품에 비해 값이 크습니다. 두께 있는 문서를 올릴 일마다 마지막 한 겹은 원고에 기억이 없는 검토자에게 넘길 생각입니다.